

A:不一定。企业数据往往分散在数仓、数据库、数据湖及业务系统中,如果先复制、搬运再供 Agent 使用,会增加建设周期和数据冗余。Aloudata AIR 支持企业建设统一的数据访问层,让 Agent 在权限和治理约束下按需访问多源数据,而非为 AI 再建设一套数据副本。
Aloudata AIR逻辑数据编织平台
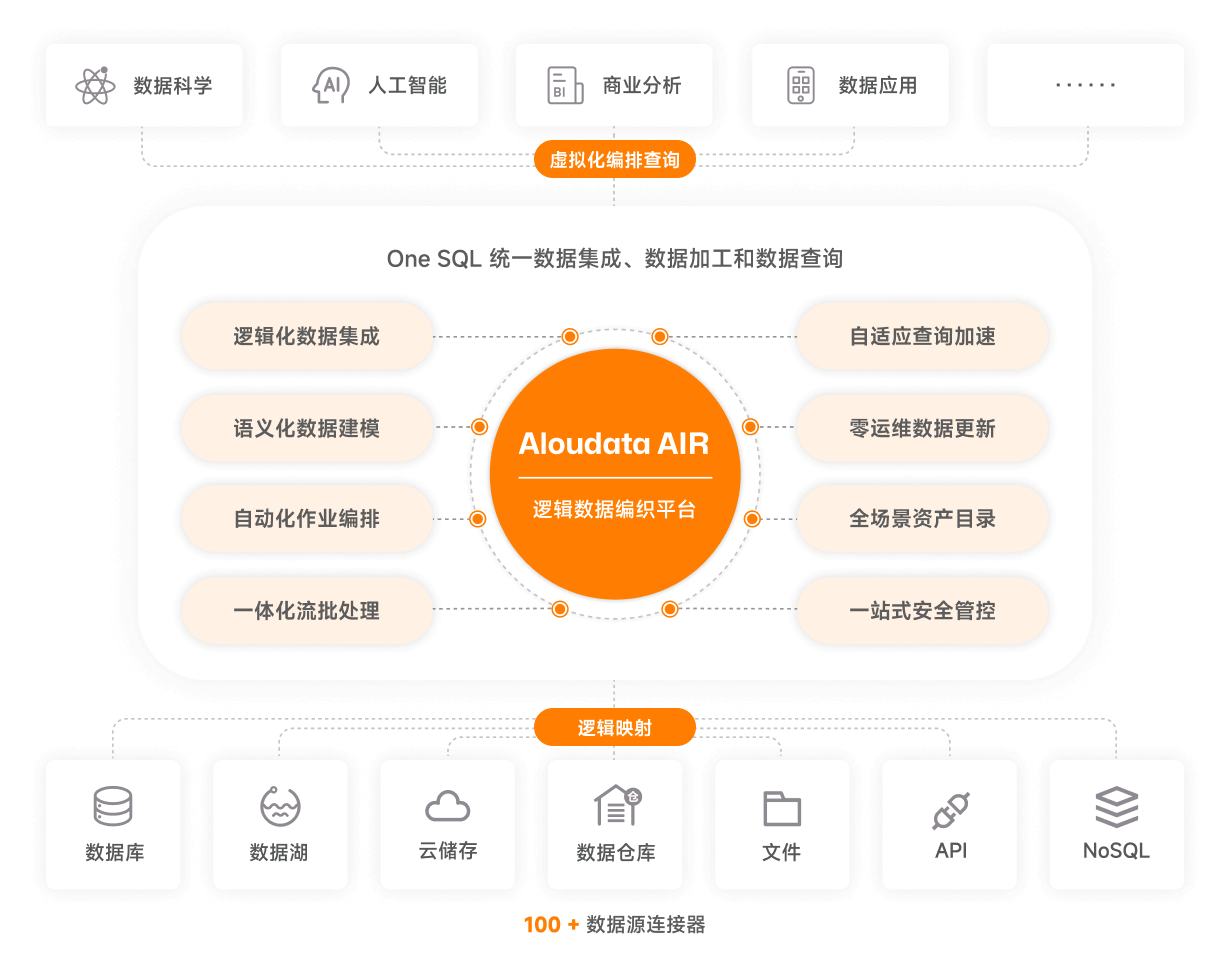
基于 Data Fabric 理念,自研国内首个数据虚拟化引擎。无需移动数据,轻松实现多源异构数据的集成交付,并通过 AI 增强的自适应加速技术提升查询性能,实现全域数据低成本实时就绪
零数据搬运,轻松实现全域数据的敏捷交付
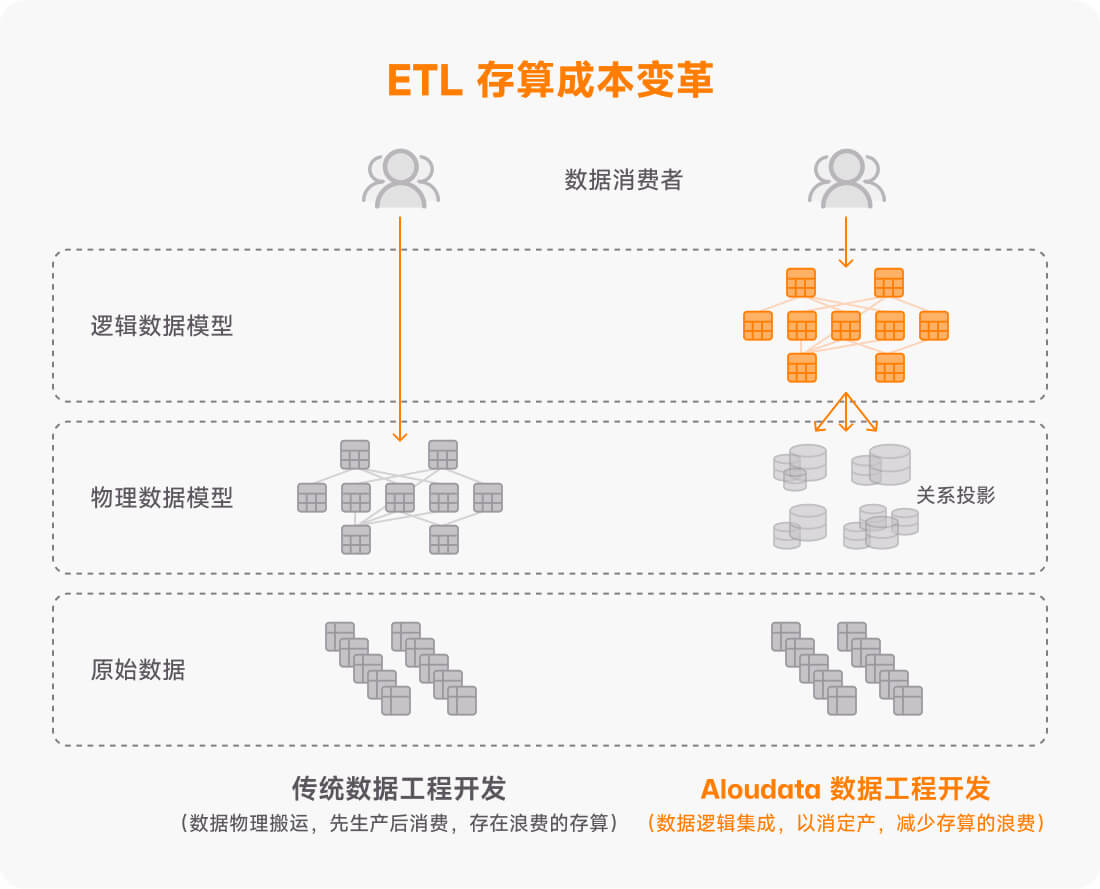
数智化时代,数据海量增长并保持动态变化,物理集中式的数据工程既不敏捷也不经济。Aloudata AIR 通过数据虚拟化技术,实现逻辑数据集成、自动化数据编排和自适应查询加速。无需关心数据存放位置、数据任务运维和查询性能优化,直接基于 SQL 即可对全域数据进行探索、加工与查询。
零搬运
秒级数据集成
Aloudata AIR 快速连接上百种数据源,无需物理集中数据,无需配置同步任务和等待同步成功,秒级完成数据集成。
One SQL
跨源、跨引擎统一查询
Aloudata AIR 屏蔽 SQL 方言差异,无需关心各类源和计算引擎的差异,用一种 SQL 方言完成全域数据的逻辑整合和统一查询;更换引擎时无需修改业务 SQL 代码,实现计算引擎的透明升级。
逻辑建模
定义即研发,变更即发布
Aloudata AIR 支持逻辑数据集的灵活定义与实时变更,变更实时生效或通过关系投影的自动化更新生效,告别复杂的物理建模与变更操作。
NoETL
智能作业编排
Aloudata AIR 通过创新的自适应关系投影(Predictive Relational Projection)技术,支持自动或手动生成与更新逻辑数据集的关系投影,支持关系投影的分区更新和级联更新。
自适应查询加速
10+ 倍提高查询性能
Aloudata AIR 可以基于查询数据规模和性能要求,通过用户查询行为理解自动化生成关系投影方案,并智能路由关系投影的预计算结果或下推至底层查询引擎,明显提升查询性能。
自治理
显著降本增效
Aloudata AIR 依据查询行为自动回收低收益的关系投影或重新选择最佳投影构建方案,相比其他加速方案,降低至少 30% 数据存算成本和 70% ETL 运维成本。
场景用例
 业务自助用数通过数据虚拟化快速连接企业已有的各类数据,以极致查询性能满足业务轻量、快速、灵活的取数需求。
 跨平台大规模数据 融合和共享不同步数据,无需大额投资存算资源,不改变数据权属关系,不破坏数据安全管控边界,跨平台、跨系统地无缝整合与实时共享大规模数据。
 跨云、跨地域数据 联合分析和查询通过"联邦本地计算"的跨境数据查询方案,在数据不流动的情况下实现境内外数据的统一关联分析和快速查询,确保数据使用过程中的合规和敏感性保护,全面提升跨境数据分析效率。
 0-1 搭建企业 逻辑数仓简化 ETL 的复杂性,基于数据虚拟化引擎轻松完成全域数据的逻辑集成、逻辑整合和统一查询,赋能企业低成本快速构建自运维的逻辑数据仓库。
价值收益
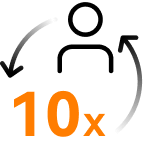
10 倍以上
数据交付效率提升
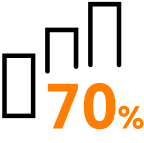
70 %以上
管理成本节约
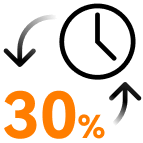
30 %以上
存算成本节约
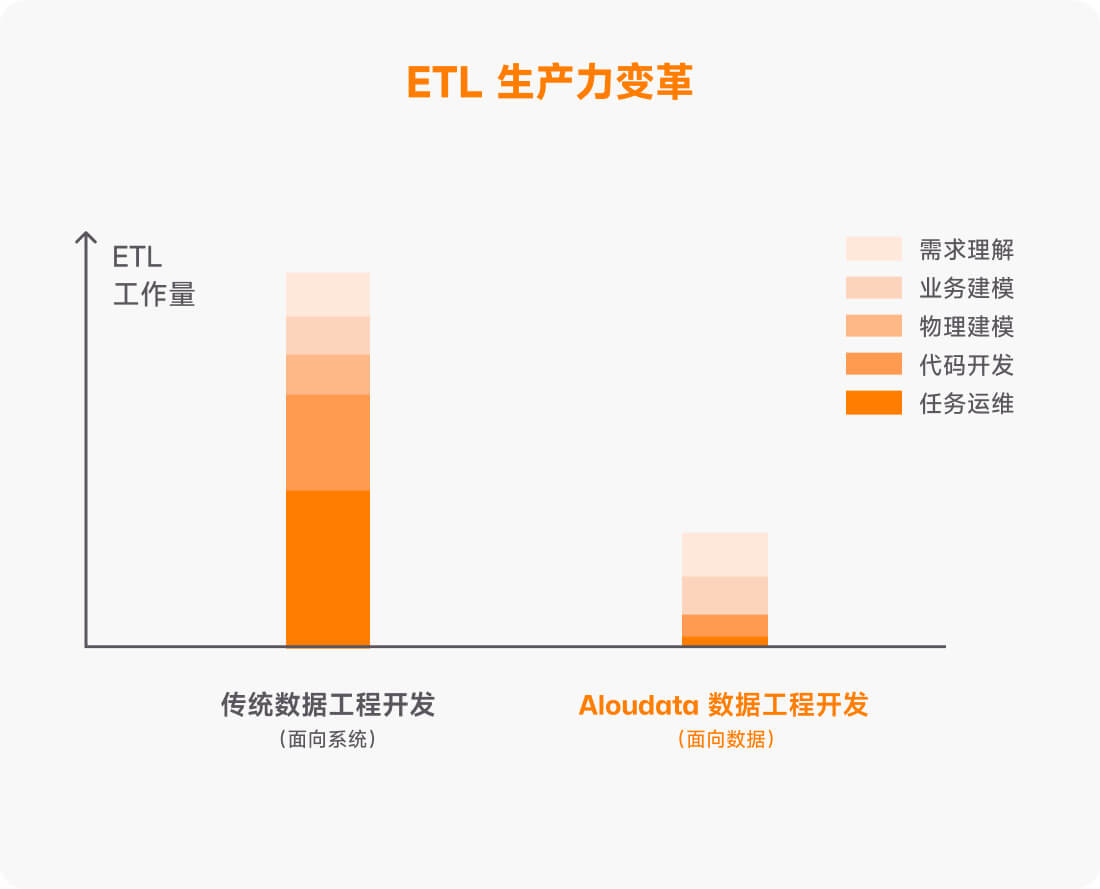
功能特性
逻辑数据集成
无需提前 ETL 搬运数据,系统自带上百种数据源的连接器,无论是云端的数据库、SaaS 软件的 API,还是本地部署的数据仓库,Aloudata AIR 都可以轻松将数据逻辑集成在一起,实现实时数据访问。

AI 数据画布
AI 数据画布帮助用户以零 SQL 方式轻松完成复杂数据开发。只需拖拽组件、输入分析需求,系统自动识别数据关联关系,生成高质量 SQL,并支持一键物化加速与视图保存,实现数据资产的敏捷开发与高效复用。
数据交付提速:拖拽式完成复杂开发流程,显著缩短数据需求交付周期
降低技术门槛:自动生成标准化 SQL 与关联逻辑,减少人工配置错误
支持性能优化:一键加速功能让查询运行更高效,应对大数据量更从容
推动数据复用:便捷沉淀数据视图,推动企业数据资产共建和持续运营
常见问题
客户案例

Aloudata x 招商银行|基于数据虚拟化的敏捷数据服务体系建设实践咨询案例详情
无需关心数据集成、任务运维和性能优化等,按需接入总分行及个人数据,自助完成数据准备
自动从上游加载数据及物化加速,数据需求交付效率大幅提高,由 2 周缩短至 1 天
避免“大 Cube”、“大宽表”的全量预加工计算,自适应查询加速 2~10 倍以上性能提升

Aloudata NoETL 助力首创证券打通数据集成与分析全链路咨询案例详情
不再受“数据孤岛”限制,逻辑化集成整合,零数据搬运,10+ 个不同数据源快速准确融合
自适应加速引擎,按需物化并自动回收无效预计算数据,全局存算成本节约 50%
无需做一对一的数据复制,无需构建传统数仓的 ODS 层,也无需关心数据存储和计算调度
解决方案