30 分钟上岗:企业“招聘”Data Agent 的新标准
10 月 23 日,Aloudata 创始人& CEO 周卫林受邀参加 2026 DACon 数智大会,围绕 Data Agent 走向企业生产环境的实际挑战,提出“30 分钟上岗”新标准,深度解析“摸得清、问得准、干得对、学得会”四项上岗能力,同与会嘉宾共探如何让 Data Agent 快速上岗、承担分析任务的新路径。本文根据现场演讲整理,约 3600 字,阅读需 13 分钟。
大家好,我是周卫林。在阿里和蚂蚁做了 15 年数据工作后,我在 2021 年创立了 Aloudata。在过去几年的探索中,我一直在思考一个问题:在 AI 时代,企业到底需要什么样的数据产品?
今天,我想从“数字员工”的视角切入,和大家探讨一下企业对 Data Agent 的采购、使用和考核方式的转变——从“买工具”走向“招员工”。而“30 分钟上岗”,也正是我们基于这一判断提出的新要求:让 Data Agent 像数据分析师一样入职,快速承担分析工作,并在持续协作中自成长。
01 Agent = f(Context)
过去,我们常把 Agent 定义为 Agent = f(LLM + Harness + Context)。
但随着技术演进,大家会发现模型能力和 Harness 工程架构正在被迅速拉齐。无论是开源还是闭源,无论成本高低,模型能力的智力已经不再是决定 Agent 能不能干活的前提条件了。同时,各种开发框架、封装程度极高的工程化组件,也让软件工程能力迅速普及。
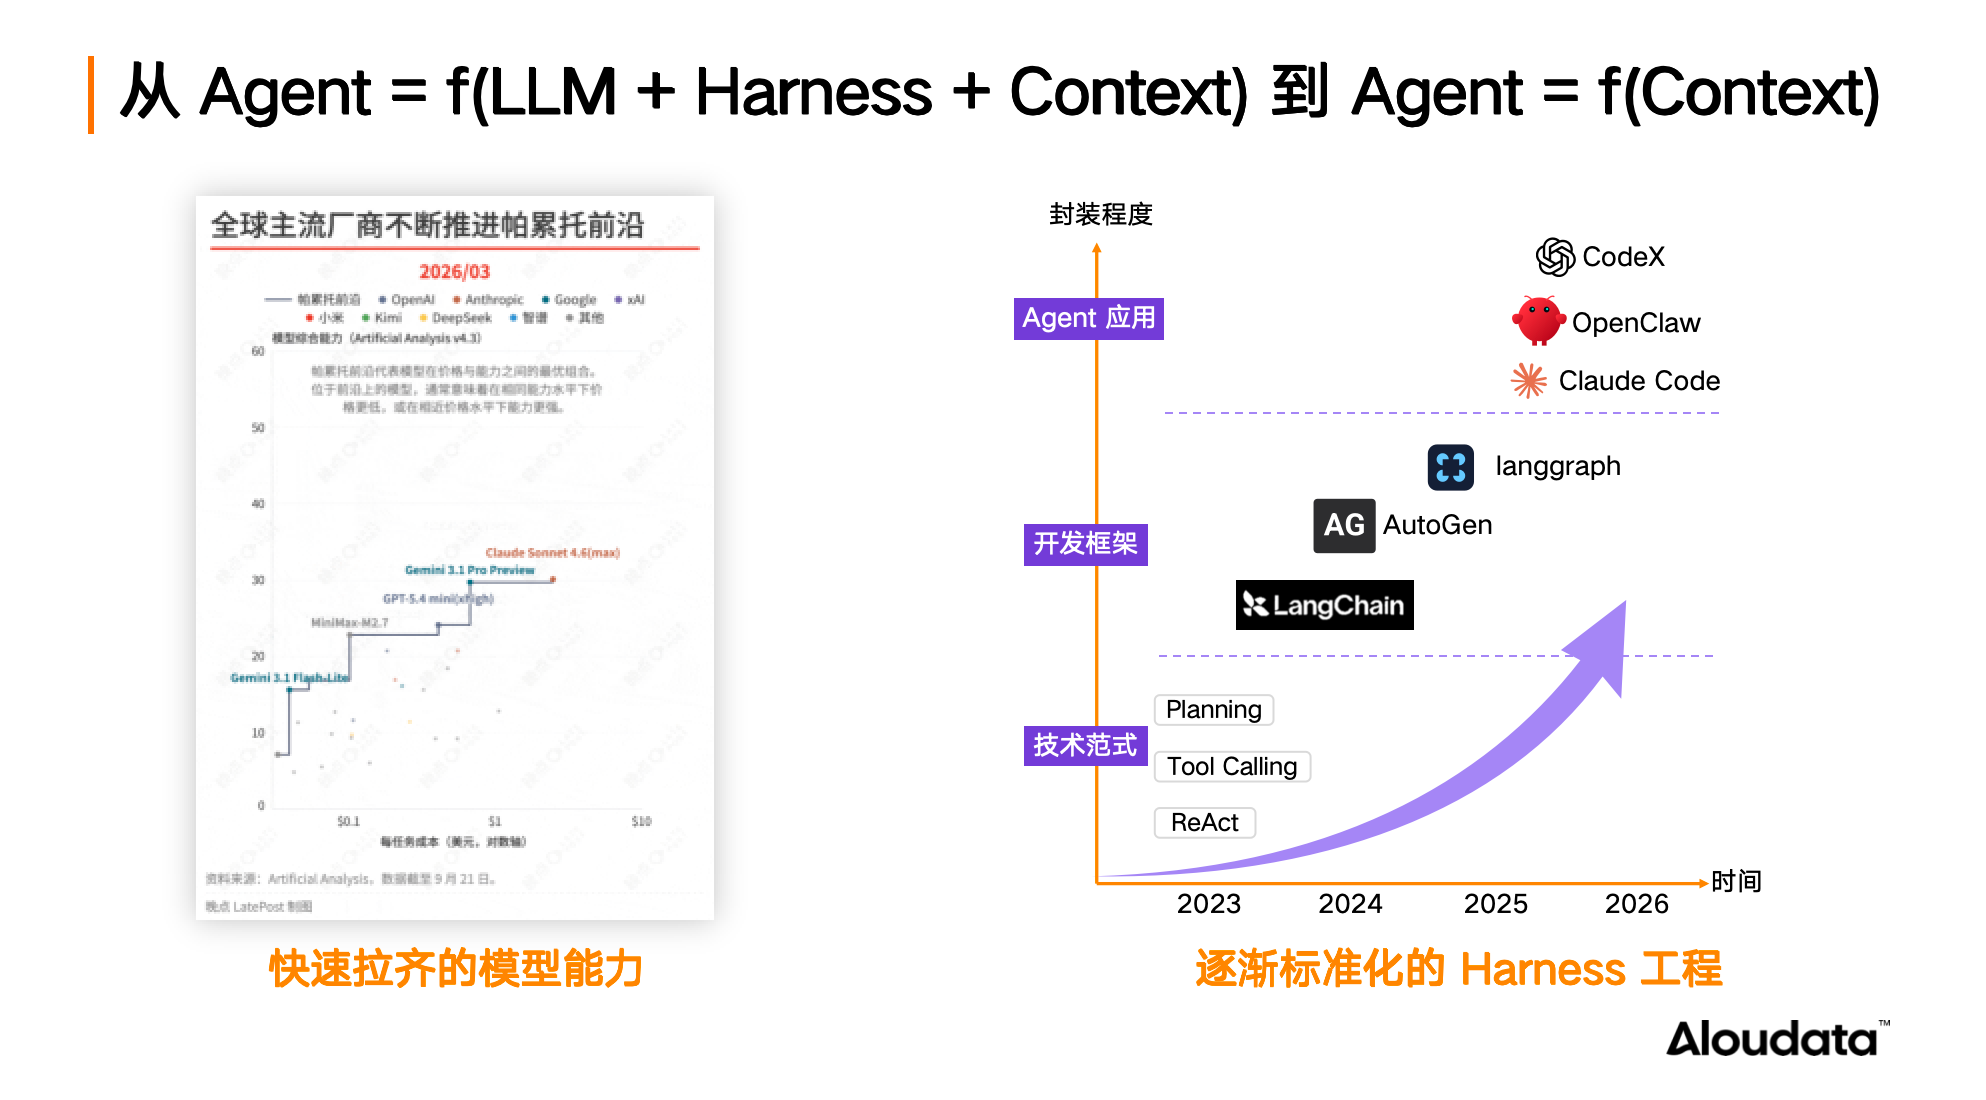
当这些基础条件被拉平后,企业与企业之间、厂商与厂商之间,最大的变量和核心竞争力是什么?答案是 Context。Context 不是能力,是事实。能力如会画画、会写作,这些都可以被大模型“吃”进去,但 Context 是企业私有的事实,大模型“吃”不进去。足够完备的 Context,恰恰是 Agent 完成任务所需的事实信息,包括业务定义、指标口径、历史知识,以及当前任务的目标和背景,否则无法完成任务。
就好比,一位分析师参加经营会议后接到取数任务,他能够结合讨论过程理解业务诉求。但 Agent 只收到一句“帮我取一下数”。因为掌握的信息不同,对同一个任务的理解和执行天然出现巨大偏差。
因此,我们认为,Context 首先是信息学,其次是工程学。需要先考虑如何采集、组织和表达任务所需的信息,再通过工程手段,让 Agent 有效获取和使用。
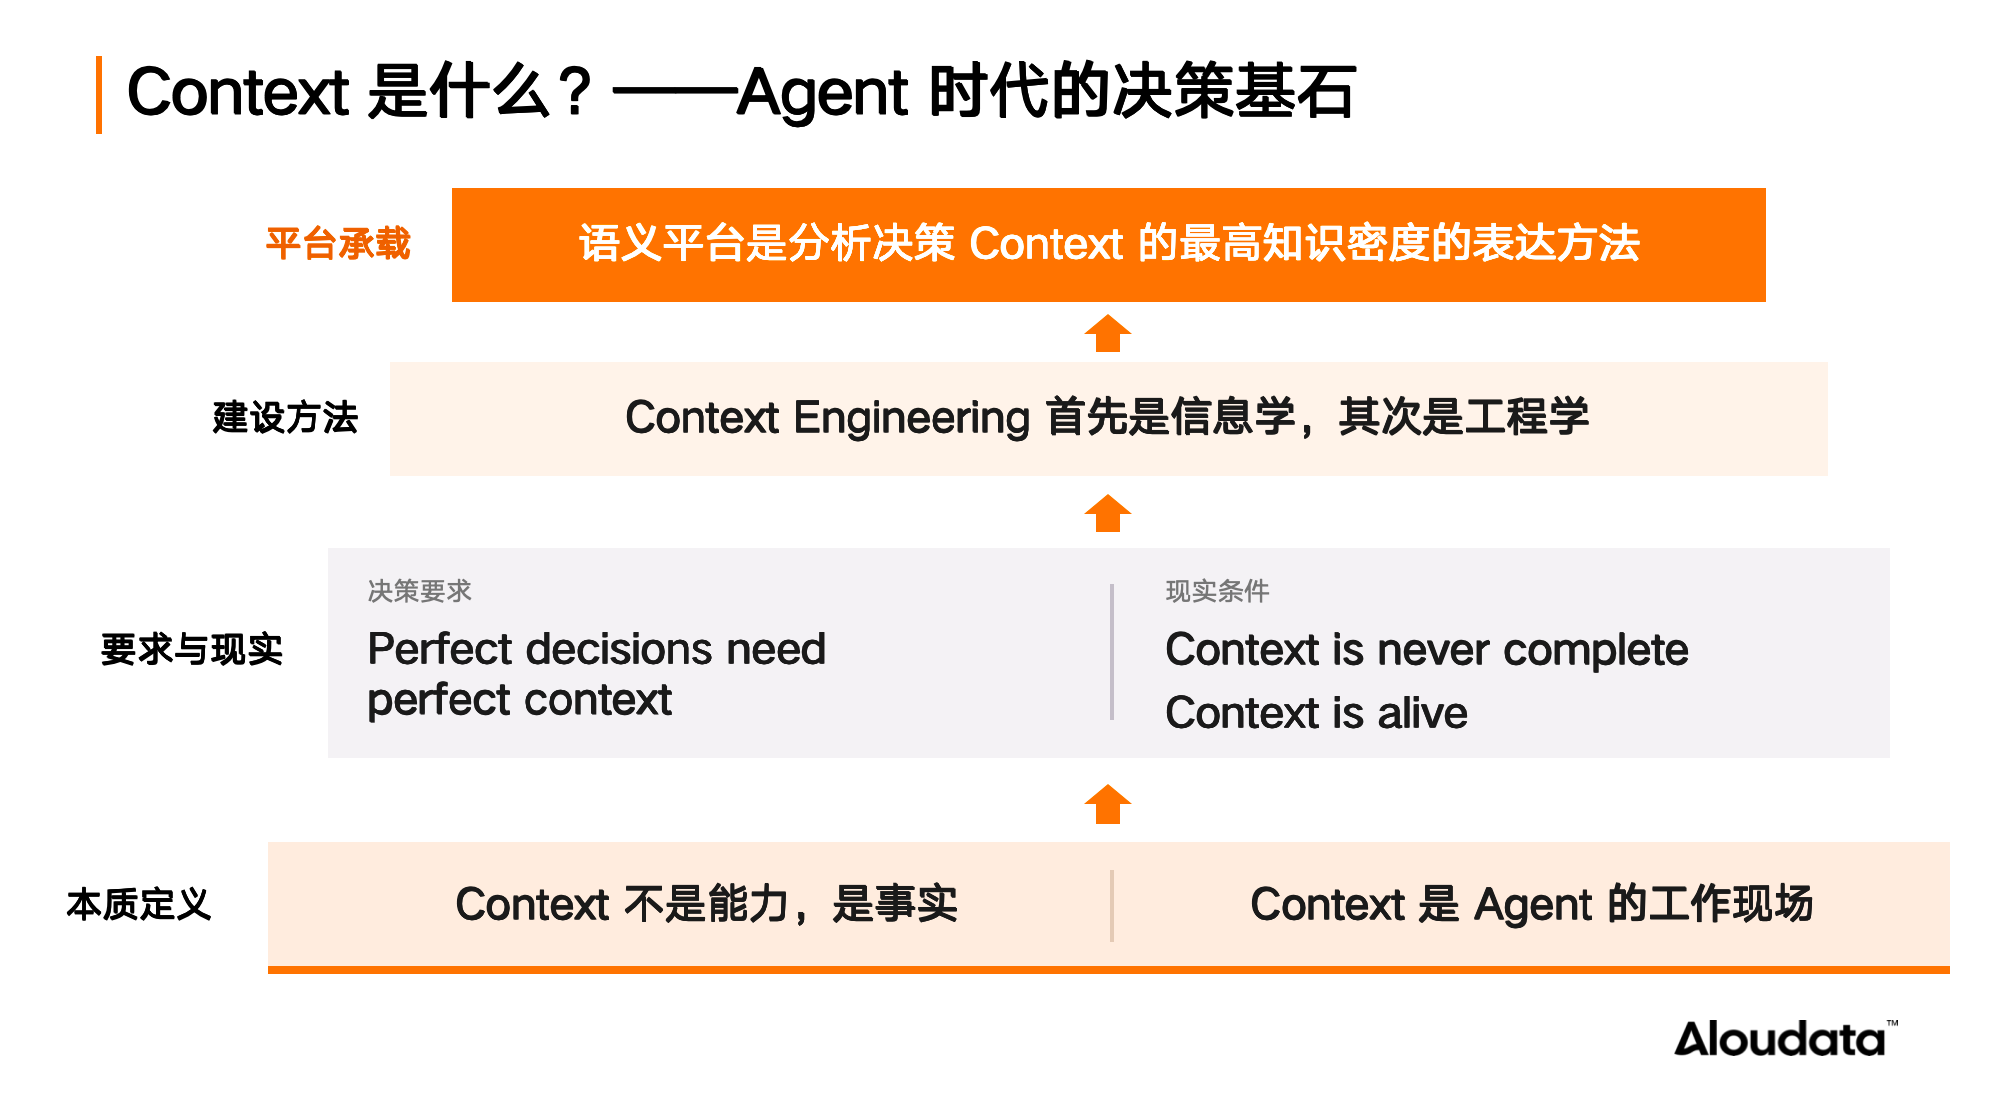
在数据分析领域,语义平台能够通过指标、维度及其业务定义,将企业知识显性化。所以,语义平台就是分析决策 Context 的最高知识密度表达方法,为 Agent 理解和使用企业数据提供支撑。但现实条件仍然充满各种挑战,特别是 Context 永远是不完整的,一直处于动态演化中。Agent 需要在工作中不断发现信息缺口,通过沟通补充背景,并持续积累经过确认的数据和知识。
02 Data Agent 上岗,从“买工具”到“招员工”
理解了 Context,我们再来看企业采购和使用 Data Agent 逻辑的变化。
在传统分析工具时代,人负责明确需求、拆解步骤、操作软件,再核验和解释结果。分析工具则承担查询、计算、可视化等功能,工作的组织者始终是人。
现在 Data Agent 带来的变化是,它不再是工具,而是“数字员工”,开始承担工作的组织与执行。
业务人员交办任务、确认口径并决定是否采用分析结果,Agent 则主动理解需求、制订分析计划、调用工具执行,核验并交付结果。双方的互动,就像是主管与下属之间的协作:主管分配任务给 Agent,然后它就可以自主完成,最后主管再来做验收。
这意味着,企业采购、使用和考核 Data Agent 的逻辑必须要改变,要从“买工具”走向“招员工”。
买工具的逻辑是:定功能 → 做 POC → 上线部署 → 试运行 → 验收;“招员工”的逻辑就变成了:定岗位 → 面试 → 入职报到 → 试用做真实工作 → 转正承担岗位职责。
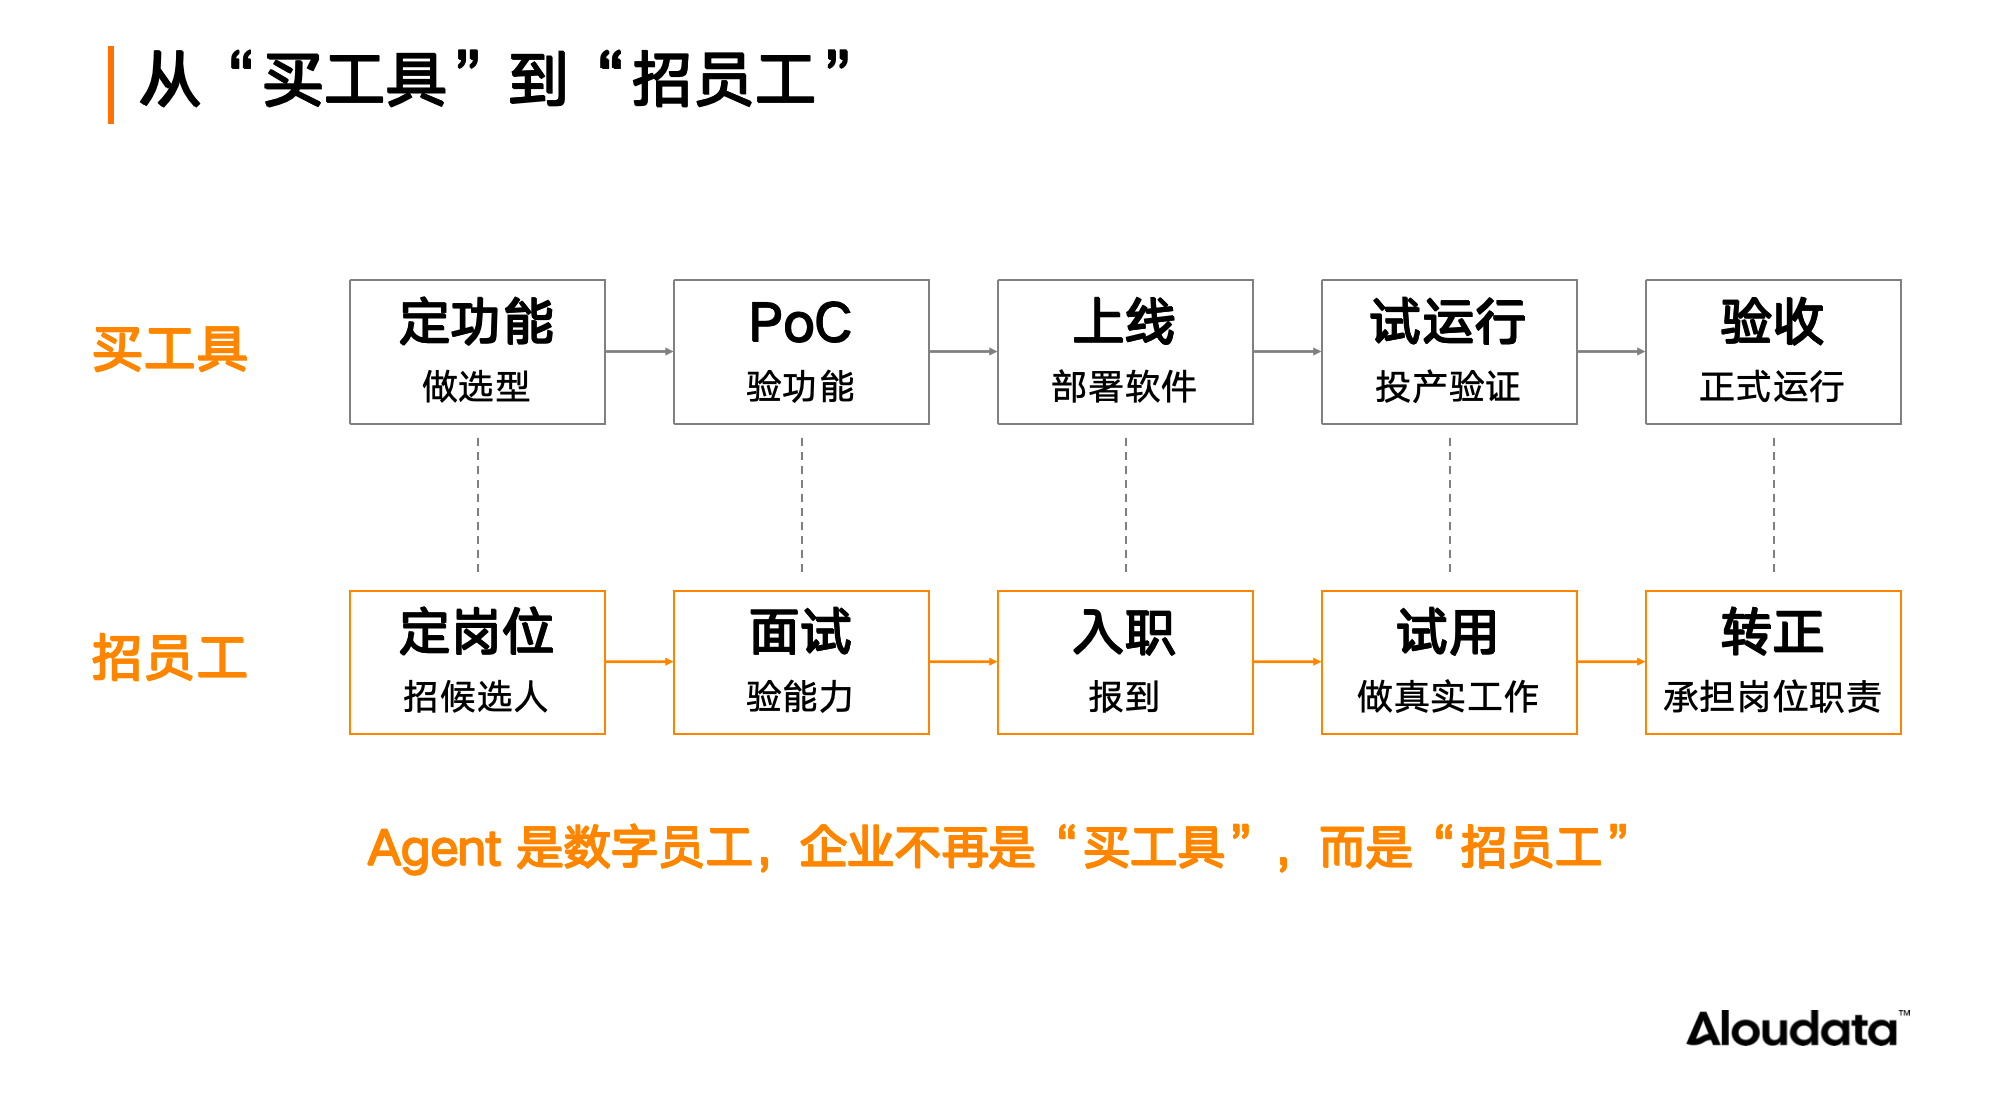
但现实中的矛盾是,很多企业还在按照“买工具”的逻辑引入 Data Agent,却按照“数字员工”的标准要求它交付。这就导致,哪怕功能测试通过后,上手成本、沟通效率和成果可信度,都可能会成为实际使用的障碍。
因此,我们更需要关注任务层面的 Agent 的表现:完成率如何?交付结果采纳率如何?以及能否在使用中自学习和自进化。此外,Agent 的工作结果具有不确定性,而业务对数据分析的要求又是“100% 准确”。如果 Agent 取出的数据不对,责任是谁的?业务敢用吗?都是企业需要考量的关键问题。
03 “30 分钟上岗”的四个能力要求
要应对上述挑战,我们认为 Data Agent 必须具备类似真实数据分析师的上岗能力:在获得数据权限和拿到岗位资料后,主动理解、整理业务知识,在真实任务中边干边学、边学边干。
1. 摸得清:从已有资产中理解业务,自动构建指标语义
新员工上岗要先熟悉数据、口径和岗位职责,但企业的业务知识,往往存在于各类报表、SQL 和数据加工逻辑中。所以 Agent 要上岗,首先需要将这些分散的知识整理成可理解、可使用的语义。
我们的实现方法是基于算子级血缘解析,像 ETL 架构师一样解析代码。从报表指标向上追溯数据加工链路,把 SQL 的算子掰开,还原计算过程,实现血缘 100% 准确的算子级、字段级的语义解析,自动化提取指标口径,将加工逻辑表达为业务含义。
有了这一基础,Agent 就可以自动盘点全域资产,把数据资产变成 AI 资产,生成“同名不同义、同义不同名”的指标列表,实现语义的自动配置。对于“指标重复”和“口径冲突”如何取舍,则需要由业务人员确认。Agent 可以提供依据和建议,业务定义的选择权仍然属于业务人员。
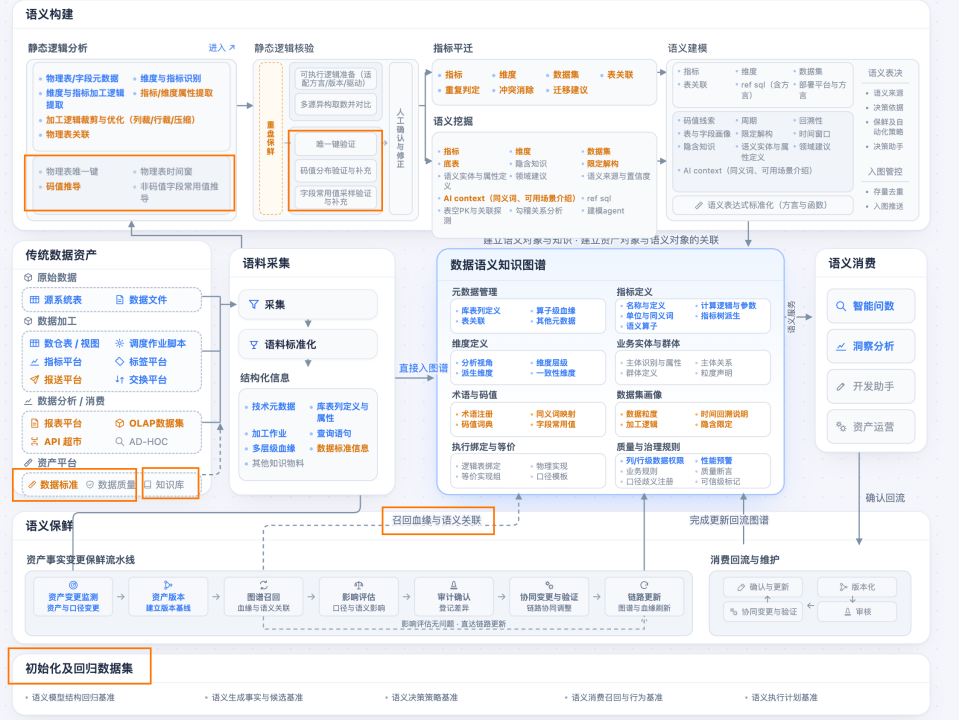
这种能力也让 Agent “边用边治、以用促治”成为可能。企业可以先开展系统盘点,也可以在真实任务中发现口径问题、确认适用范围,让治理与使用相互促进。
2. 问得准:有依据地反问,把需求口径确认清楚再执行
“这个月,企微流失了多少好友?”看似明确的问题,可能对应不同的统计结果。
假设一位顾客月初是企微好友,月中删除,月底又重新添加。如果统计“本月发生过删除的好友”,这位顾客应计入流失;如果统计“期初是好友、期末已不是好友”,则不应计入。
模型天生容易脑补,如果它不知道自己不知道什么,就会把假设当成事实。
因此,Agent 要能够主动反问:“你想看期间发生过的流失,还是期初好友到月底的流失?”而有效反问的前提,则是 Agent 掌握了企业的已有知识,知道哪些定义会影响结果。所以“问得准”需要遵循三个原则:
- 有歧义先确认,不直接把最接近的指标当作答案;
- 给出的选项要对应真实业务定义;
- 缺少信息时,要明确说明缺什么,请用户补充。
更深一层的要求,是识别自身的知识边界。企业已有答案但 Agent 尚未获取时,需要补充 Context;已经发现信息缺口时,需要澄清;尚未察觉的盲区,则需要通过评测、观察和追溯逐步暴露。
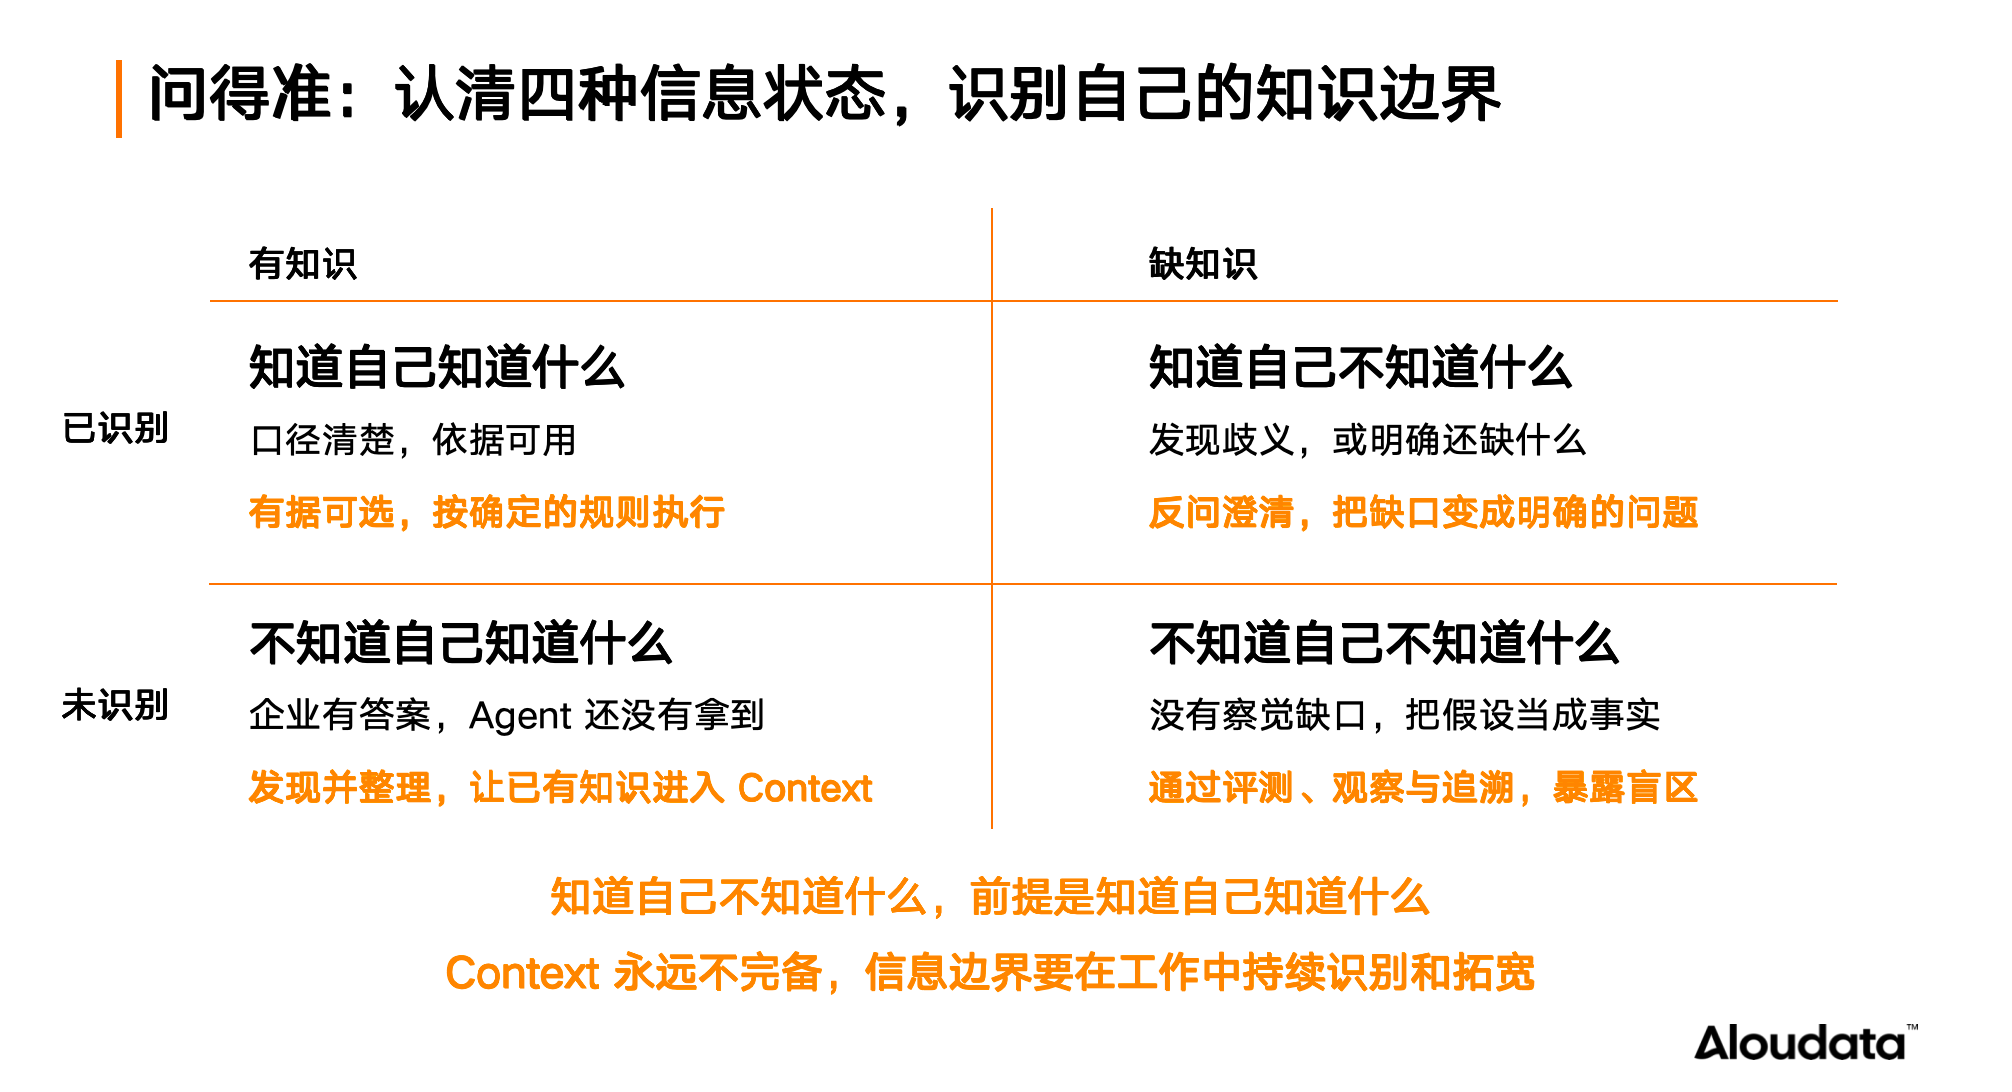
知道有什么,才知道该问什么。我们需要让 Agent 把已有知识变成选项,把信息缺口变成明确的问题,减少将假设当作事实的风险。
3. 干得对:看得懂过程、找得到依据、查得清操作
业务人员要求数据 100% 准确,因为结果将用于决策。而 Agent 面临的现实问题是:任务目标、业务背景和口径信息可能不充分,理解上就会产生偏差。因此,保障数据准确性,就必须建立在一个可检查的工作机制之上,让关键判断与执行依据充分透明,使偏差能够被发现、被定位,并被纠正。
这也是我们强调“只有分析过程 100% 可信,才能保障数据 100% 准确”的原因。面对不完备的 Context,准确性的保障需要贯穿沟通、执行与核验全过程,不能只依赖模型一次作答。
具体而言,需要建立三方面的能力:
- 工作过程可复盘:提供完整的思维链,展示工作规划、执行步骤和关键判断,让用户看得清任务如何开展;
- 分析结论可追溯:提供完整的数据链,将结论关联到指标口径、来源引用和数据血缘,让用户找得到依据;
- 全程操作可审计:提供完整的审计记录,保留工具调用、操作痕迹,为后续核查提供依据,让用户查得清操作。
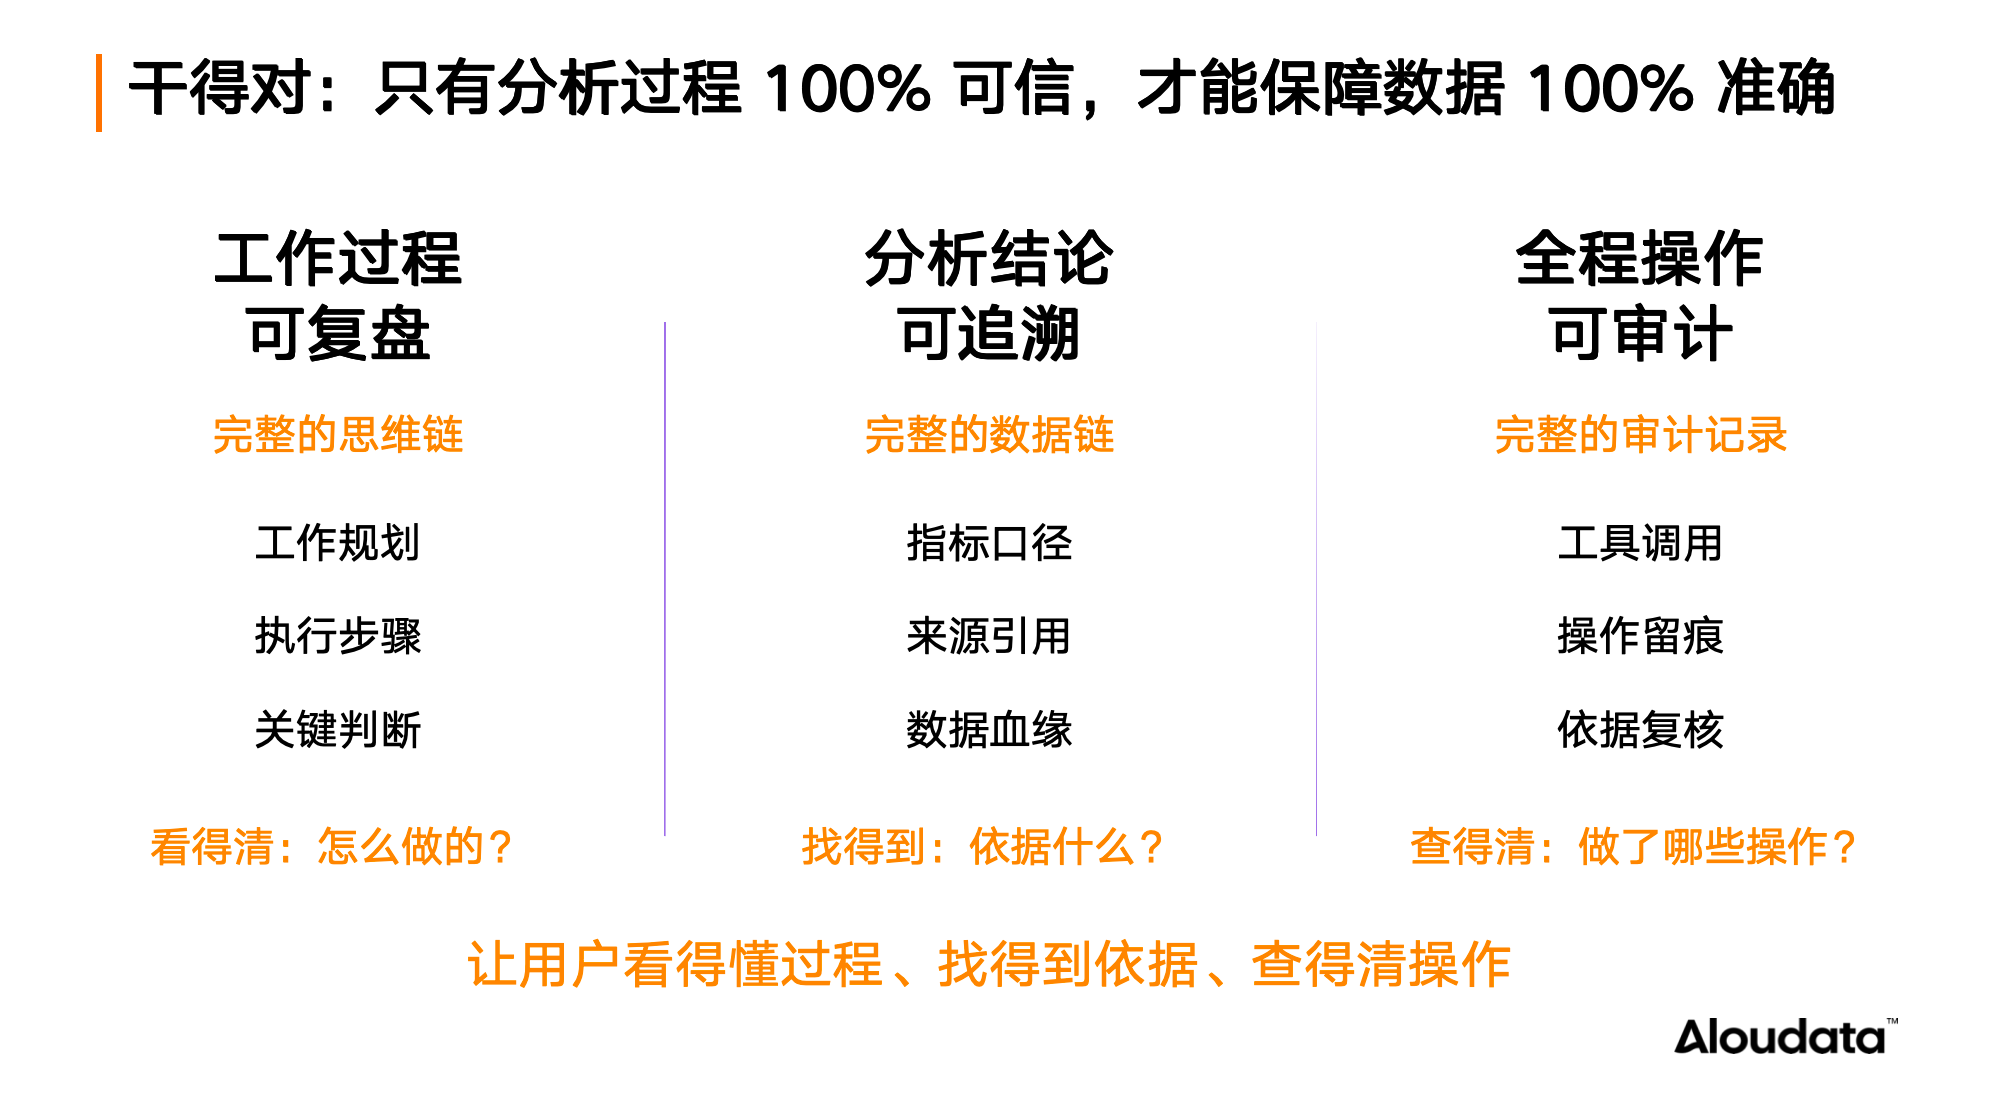
例如,当某个数字出现疑问时,用户能够沿着链路检查:Agent 如何理解需求,匹配了哪个指标,这个指标采用了什么口径,背后的 SQL 加工逻辑是什么。一直向上追溯,定位到具体环节,才能判断问题出在需求理解、指标匹配,还是语义配置,并进一步改进。
通过这样的透明机制,让业务人员能够核验成果,也让问题有据可查、改进有处着手。
4. 学得会:改进可验证,经验可复用,进化可管控
一位员工需要在工作中积累经验,Agent 也需要将真实任务中的过程、结果与反馈,转化为后续可以复用的能力。我们将这一要求概括为:改进可验证,经验可复用,进化可管控。
对此,我们通过“开发态 + 运行态”的两级评测,确保 Agent 改进有效。而经过确认的知识和经验,再根据适用范围沉淀到个人、项目或部门、公司三个层级,以持续更新 Context,供后续任务使用,并把每一次任务中的反馈、纠正变成下一次做得更好的能力。
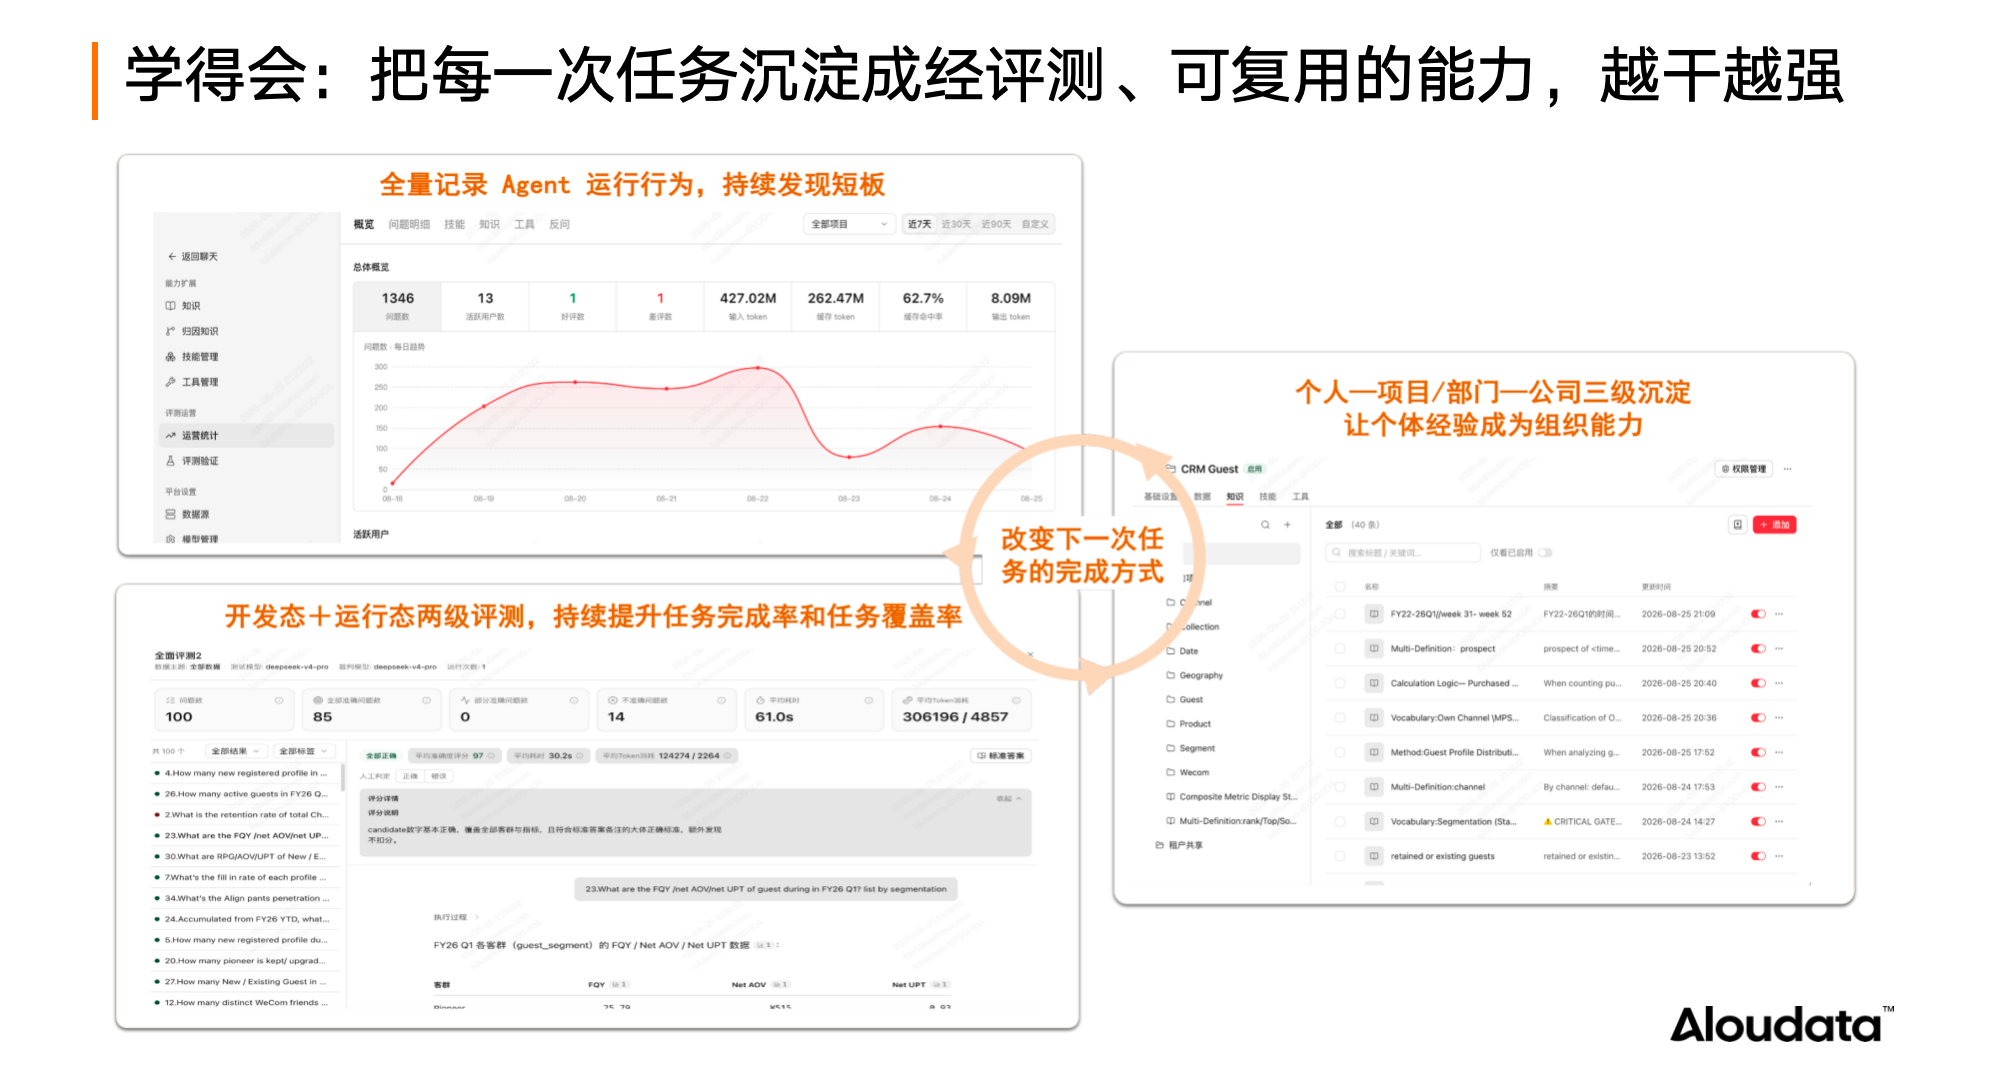
例如,一项指标口径经过反问和确认后,如果适合作为后续任务的默认知识,就可以在相应范围内保存,减少重复沟通。
我们关注的是一个可检验的成长闭环:从真实任务中积累经验,经评测确认改进,再将适用的知识带入下一次任务,让 Agent 越干越强。
04 Aloudata Agent,向企业递交一份求职简历
当 Data Agent 具备了这四个能力,它的产品形态和商业模式也将发生根本改变。
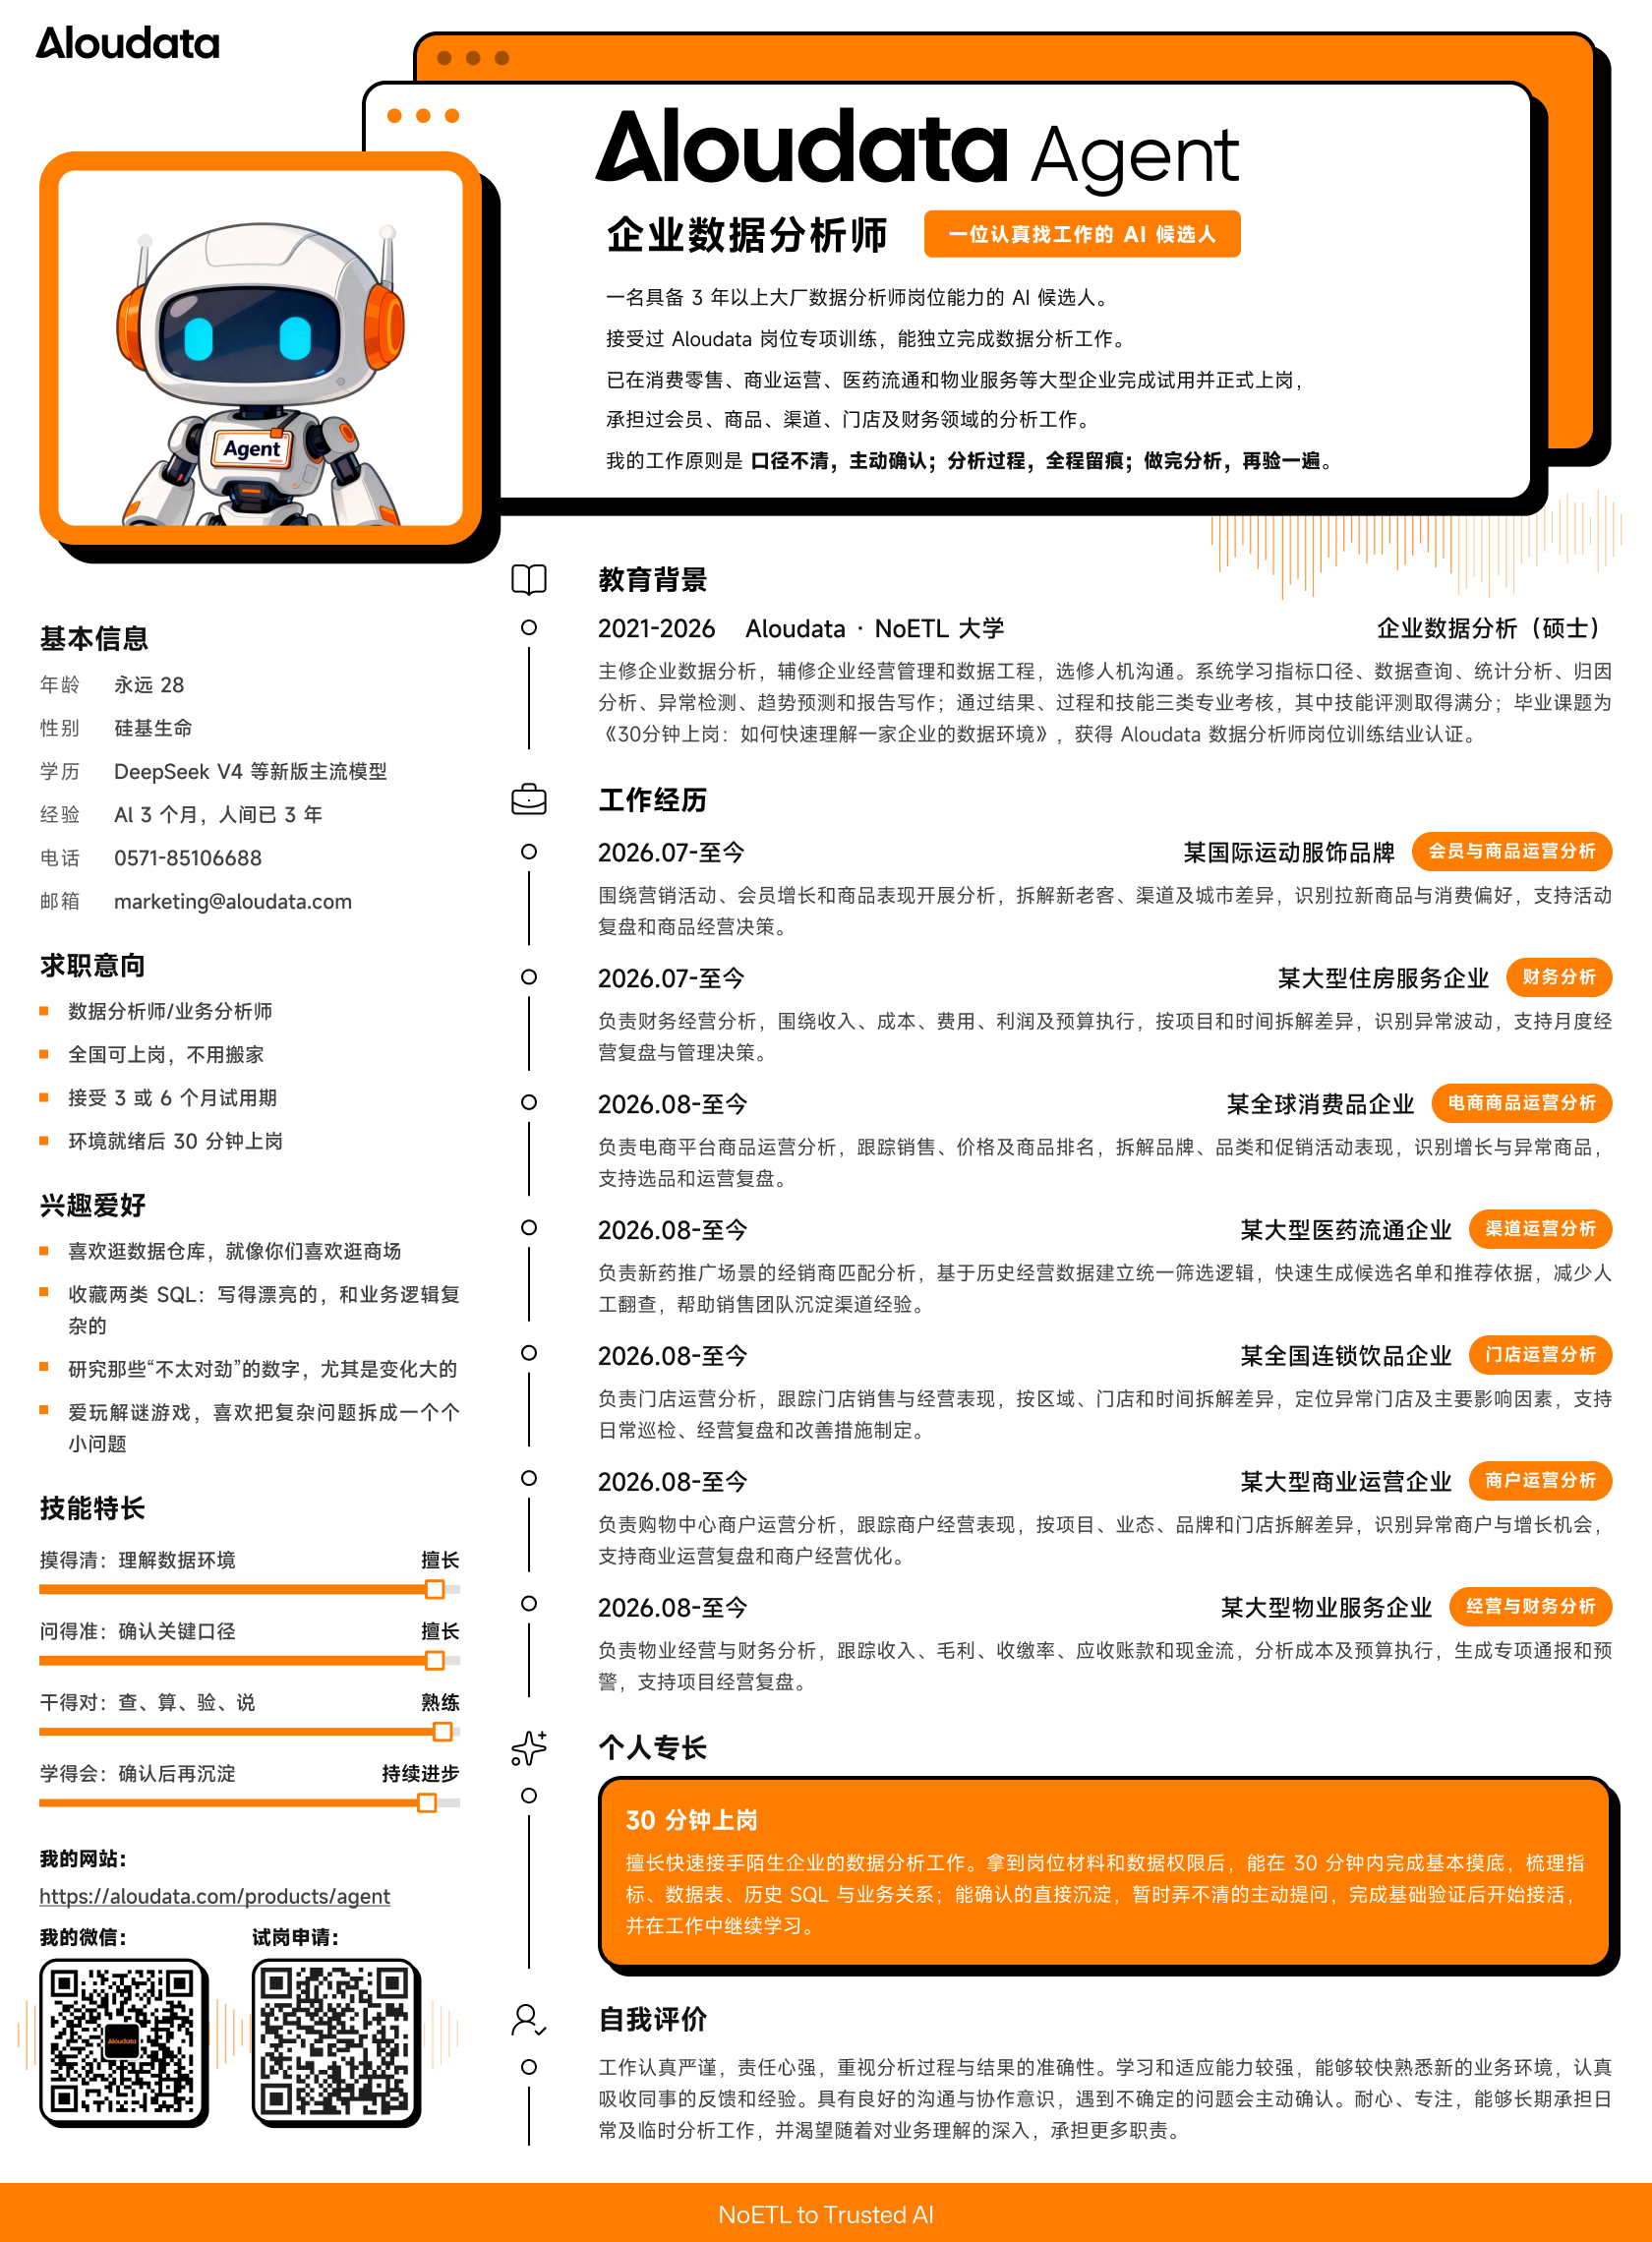
作为一家提供 Data Agent 的厂商,我们交付的将不再是一个软件,而是一个 “数字员工”。在此,我们为 Aloudata Agent 数据分析智能体准备了一份求职简历,希望将其放到企业的真实生产环境中去验证能力如何,判断它能否承担分析师的岗位职责。
欢迎查看下方应聘简历,扫码申请试岗,让我们从一项真实的分析任务开始。
Topic Hub
AI 数据智能