星河案例ㅣ招商银行:基于算子级血缘的数据治理创新实践
01 案例企业
招商银行成立于1987年,是中国境内第一家完全由企业法人持股的股份制商业银行、是国家从体制外推动银行业改革的第一家试点银行。截止2022年末,总资产规模达到10.14亿元,连续多年荣获中国最佳银行奖项。
“科技创新驱动”是招商银行的核心战略之一,招商银行持续加快推进数字化转型,在国内大中型银行中率先实现全面上云,构建“一朵云+两个中台(数据中台和技术中台)”的金融科技新基建,围绕线上化、数据化、智能化、平台化、生态化,全力打造“数字招行”,助力建设“数字中国”。
02 项目背景
招商银行一直致力于将前沿的金融科技技术应用到数据管理领域,保持金融科技银行的领先地位和优势。目前招商银行总行数据湖内整体的数据量已经达到了数十PB,资产规模增长到10多万张表,每天有几十万个数据处理任务在运行,每月有近4000多位用户进行数据分析和开发工作。
随着行内数据生态日益复杂,招商银行总行数据管理工作面临两大挑战:
第一,如何持续有效的保持数据架构的先进性。随着数据复杂度的指数级增长,数据消耗成本不断增加,用户对数据“好找、好用”提出了更高要求,数据架构需要持续优化,与时俱进升级,否则难以满足日益增长的业务需求。
第二,如何高效地开展全链路的变更协同。随着业务对数据的依赖越来越深,数据加工链路关系变得错综复杂,一点细微的变化都可能牵一发而动全身,极大地增加了风险出现的概率,数据质量保障要求越来越倾向于全链路协同。
在当前的业务趋势下,数据架构治理难点重重,数据加工链路关系错综复杂,想要实现数据架构的持续优化和全链路变更协同存在着很大的困难。
在数据架构持续优化方面,数据模型是支持业务数据需求的核心载体,同时也是数据架构的核心要素,其建设的好坏直接关系到业务数据化决策的效率和质量。但随着数据复杂性指数级的增长,企业数据领域出现如下趋势,第一,数据量达到PB级以后,开发人员对于整体链路理解和梳理的工作量投入成倍增加,银行大范围模型优化的难度越来越大,持续优化工作难以实现;第二,湖仓任务量增长迅速,目前已超过数10万,对于产出时效优化的诉求日益增多,给应用的时效保障带来巨大压力和成本;第三,数据消耗成本快速增长,管理成本越来越高,增加了企业的经营成本。
传统专家驱动的运动式的模型治理方式已经不能满足当前业务需求。一方面投入成本太高,靠人工梳理的数据链路方式难以看清全局,影响模型优化的效率和治理成果;另一方面,治理效果难以持续,随着业务的快速发展,类似的问题还会重现。因此,招商银行需要一种不依赖于人工的、可持续主动治理的方案,以长期支持数据架构治理工作。
在全链路变更协同方面,数据变更是数据质量问题发生的主要原因之一,质量保证亟需端到端,看清楚上游变更对下游重要业务应用的影响,如果缺乏精细化影响面分析能力,全链路的变更协同就只能依赖人工上报风险,导致上下游人工协同的工作越来越繁重,质量保证的效果和效率难以满足业务预期。
其中主要有两方面的挑战:第一,人工保证可靠度相对较低,容易出现漏报或上报通知范围不全,只通知部分相关人员,导致相关资产出现数据质量或者时效的问题;第二,人工保障成本较高,一点变动需要分析非常多的链路,才能判断其影响范围,分析后还需要和相关方大量沟通审批,协同成本极高。
随着行内行外对数据质量保障的要求越来越高,招商银行迫切需要借助技术手段实现高效可靠的全链路数据质量保障。
03 解决方案
传统的数据技术和专家运动式治理方式已经不能满足招商银行的数据管理需求,为此招商银行进行了新的技术探索。在调研和分析资产盘点、重复治理、监管溯源、质量保障等场景难题时,招商银行发现精细化的血缘以及元数据智能技术是解决这些问题的一把钥匙。精细化血缘指的是通过理解字段的加工口径,建立比字段依赖关系更精细的血缘加工关系,精细、准确、全面的展示数据链路。
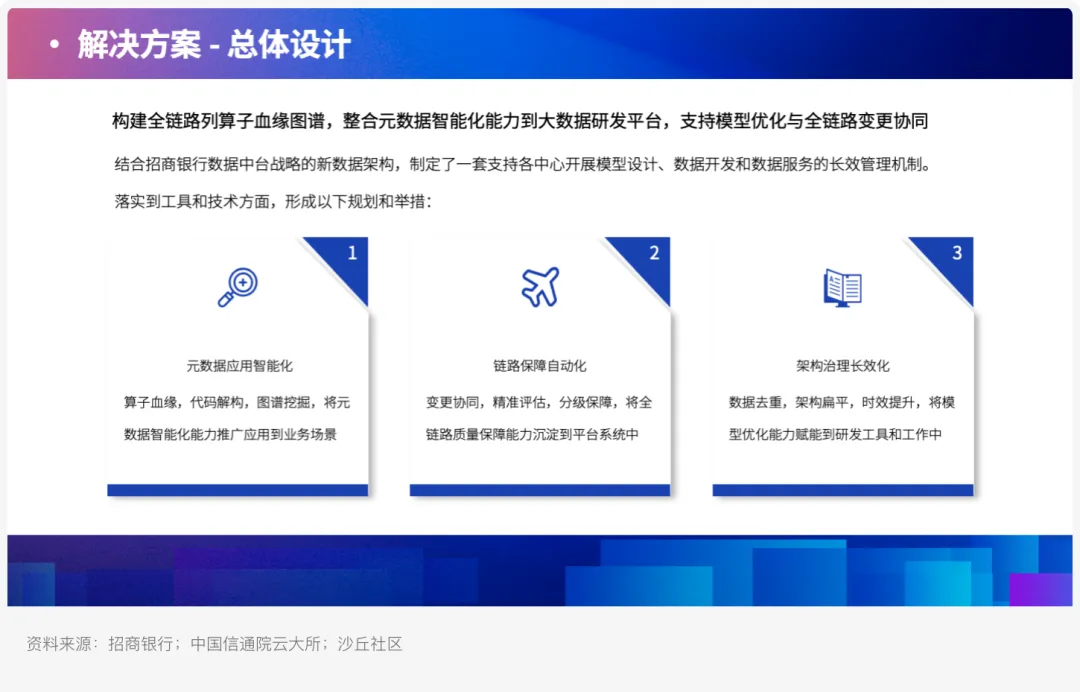
借助大应科技在主动元数据领域的先进经验和技术,以及招商银行数据中台战略的新数据架构,制定了一套支持各中心开展模型设计、数据开发和数据服务的长效管理机制。
落实到工具和技术方面,招商银行形成以下三项规划和举措:
第一,升级元数据智能化应用。落地算子血缘、代码解构、图谱挖掘技术,将元数据智能化能力推广应用到业务场景中。具体来看,血缘精细程度升级到列算子血缘,支持精准的影响面和溯源分析,提供血缘图谱的二次开发能力,为上层业务应用提供元数据驱动的智能化支持。;
第二,逐步实现链路保障自动化。将变更协同、精准评估、分级保障等全链路质量保障能力沉淀在平台系统中,借助血源的精准影响分析能力,打通上下游的协作通道,建立了事前、事中和事后的三次握手,变更协作机制,利用精细的列算子血源,精准识别重点链路保障的资产范围,对重点链路上的资产变更进行保鲜,建立重点链路分级保障和差异化的研发要求。
第三,推进架构治理长效化。提出数据去重、架构扁平、实效提升的创新解决方案,将模型优化能力赋能到研发工具和工作中。比如,准确量化资产的重复度,为基层治理提供科学依据,识别不必要的冗余依赖,缩短整体数仓链路的深度,改进数据产出实效。
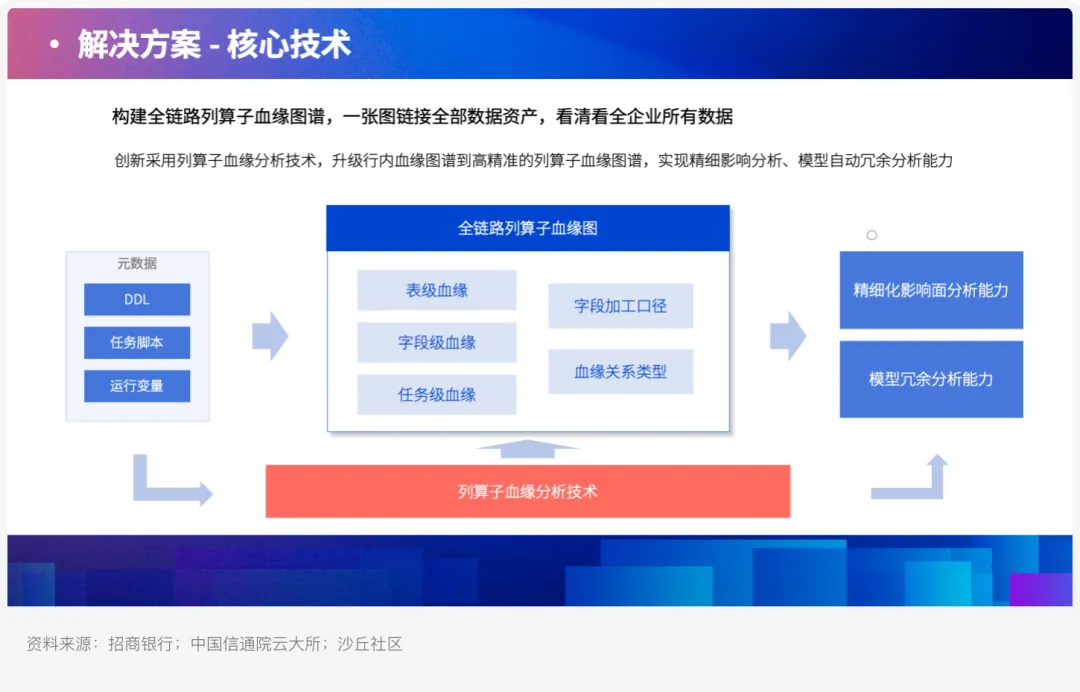
实现精细化血缘和元数据智能能力,需要采用算子血缘分析技术,参考主动元数据理念进行开发,主动元数据是数据编织架构所包含的核心能力之一。这项技术主要体现在三个方面:
第一,一张图构建元数据统一服务。提供标准的云数据采集方案和元数据模型,将企业中异构、分散的元数据汇集起来进行统一管理,实现企业统一的元数据管理和服务,构建一张企业的数据资产图谱。元数据采集包括数仓中所有的DDL、任务脚本以及运行变量,并进行每日解析。
第二,算子级血缘解析。细粒度血缘解析能力提供表级血缘、字段级血缘和任务级血缘,并提供可视化图谱,算子级血缘技术支持自动解析字段加工口径,根据数据处理逻辑细分血缘关系类型(直接血缘关系和间接血缘关系),提供精准字段影响面和溯源分析。
第三,高精准分析。采用多层SQL解析器融合架构,重构各平台的SQL方言、解析规则,兼容企业数据研发规范,在招商银行内部实现血缘解析成功率99.9%,可以量化血源准确率的监控指标,白盒化展示解析错误的归因,不断改进和维持血缘的准确率。
最终构建出算子级精准血缘图谱,通过一张图链接全部数据资产,看清、看全企业的所有数据。基于列算子的血缘图谱还可以进一步构建精细化影响分析能力、模型冗余分析能力。
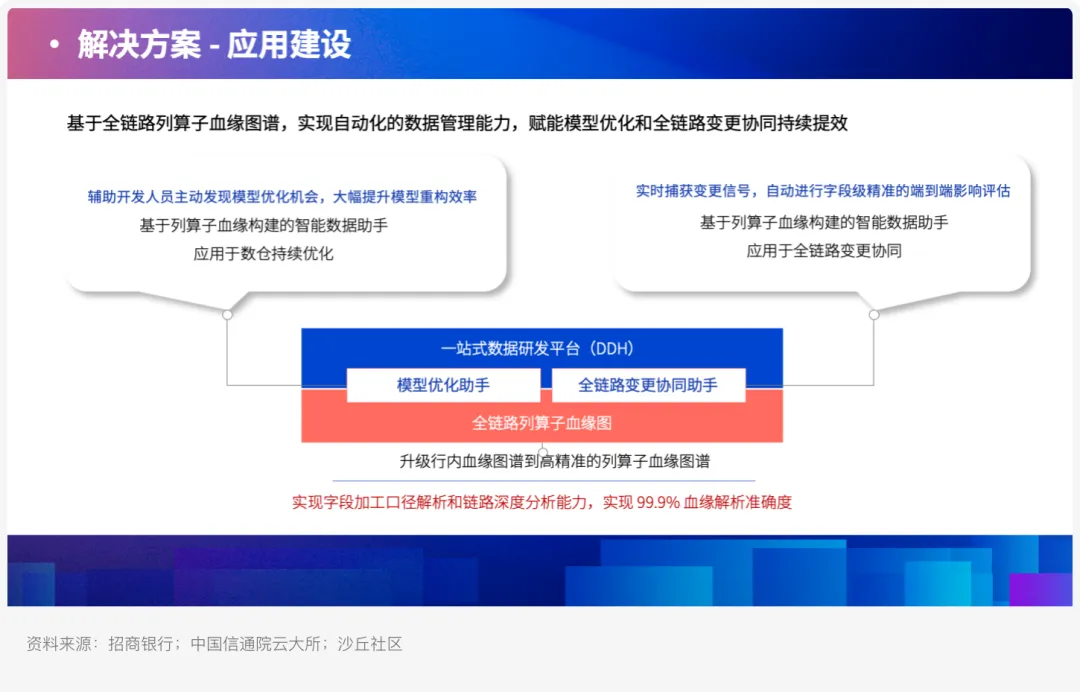
基于算子血缘,招商银行构建了与研发平台功能整合的数据智能助手应用,提供自动化场景方案,用于解决数据管理瓶颈。目前,招商银行主要构建了两个应用助手:
第一,全链路变更协同助手。在连接所有数据资产精细化血源图谱的基础之上,区分重点链路。主要体现在几个方面,其一,基于字段级血缘能力自动标记某重点场景的相关资产,对全链路上的重点资产实现差异化的研发和运维要求,减少链路异常风险,提高协同和应急的响应效率;其二,对变更事前、事后进行相应保障,代码变更前精准分析变更内容的下游影响,提前评估变更风险,代码变更后,自动获取变更内容,精确定位影响范围,重点链路自动通知下游,提高协同效率。
第二,模型优化助手。根据数据加工口径,自动找出模型合并机会和冗余计算优化机会,整套方案可以在极短的时间内自动盘清指定范围内的数据模型,相比现有的人工盘点方案,至少40%字段不需要用户进一步分析,相比人工分析可以提效10倍以上。
事前获取建模建议,沿血缘分析上下游具备相同业务组件的同粒度模型,提取字段加工口径和逻辑进行差异比较,识别相似或者相同加工口径的字段,评估相似资产合并方案,基于同粒度模型,模型优化助手可以识别出哪些表可以进行合并,也可以清楚地知道和其他表之间的这个冗余度;事后进行模型保鲜,自动评估、扫描下游的相似资产,发现新的业务需求或者推动下游重复资产下线。
模型优化助手除了模型合并和冗余计算外,还可以帮助开发人员分析复杂任务代码,快速理解上下游依赖,提升任务部署和代码迁移效率。用户可以使用任务血缘代码探索功能,不需要人工分析原始代码就可以快速理解指定字段的加工逻辑,以图形化的方式查看代码的加工逻辑、数据来源,相对于人工分析阅读原始代码,效率提升10倍以上。
模型优化助手能够快速理解字段加工逻辑和链路关系,对于直接加工的字段,还可以从图谱上获取字段链路可以合并的提示。不仅仅是表级合并,还可以在字段级给予提示。
当前,招商银行已经将全链路变更协同助手和模型优化助手整合到银行一站式数据研发平台(DDH)中,保障优化工作和开发场景深度融合,代码开发过程中,开发用户可以直接使用这两个助手。
04 价值与效果
经过近1年的建设,招商银行已经基本构建全链路算子血缘图谱,将列算子血缘分析技术应用到模型优化和变更协同的场景中,服务全行的数据开发人员。项目收益体现在如下三方面:
第一,将行内血源图谱升级到高精准列算子血源图谱,实现字段级加工口径解析和链路深度分析能力,血源解析成功率已经提升至99.9%,确保每日变更和新增的元数据、脚本都能够被正确解析。
第二,将算子血缘的精准溯源和影响力分析能力运用于全链路变更协同,增强重点链路保障场景中的链路资产保鲜能力,自动评估上游资产变更对链路下游资产的精准影响,准确定位影响范围,减少10倍的协同人力成本和数据修正成本。
对于表的血缘分析,一张表的分析三层下游就已扩散到上千张表,而通过算子级血缘,以字段粒度分析下游真正有影响的任务时,下游扩散数据将大幅缩减。以招商银行的实际案例为例,一个应用广泛的表分析三层达到1万个表,用字段级的列算子分析时直接缩减到700张表,分析任务量大幅下降。
第三,基于算子血缘开发智能化模型诊断和优化能力,应用于数仓的持续优化,并且辅助开发人员主动发现模型优化机会。大幅提升模型重构效率,直接推动数据仓库快速实现资产数量下降40%,平均数据链路缩短50%。在日常的链路保障中,自动监测上游变更,自动评估精准到字段的端到端影响,帮助运维人员预防和快速定位数据风险,让上下游的协同丝滑衔接。
05 实践总结
基于算子级血缘的数据治理帮助招商银行大幅提升模型优化和变更协同效率,形成模型设计、数据开发、数据服务的长效管理机制,创新方案具备行业可复制性,能够较好地解决现代企业所面临的数据治理通病和难题。
对于其他企业来说,本项目可参考如下经验:
第一,列算子技术是一种创新突破,采用多层SQL解析器,融合架构,重构了各平台的SQL方言、解析规则,兼容各种写法的数据代码,实现精准的列算子血缘字段口径提取,支持进一步构建上层元数据智能应用;
第二,招商银行本技术方案与大应科技联合开发,采用的开源工具 (主要包括 Antlr、Calcite等)授权协议无商业版权纠纷;
第三,列算子技术是主动元数据乃至数据编制架构落地的关键技术,可以构建更多上层应用,赋能数据研发、数据管理、数据质量、数据价值运营等,支撑数据要素价值释放。