Claude 做数据分析的这两年
2026 年 6 月,Anthropic 的数据团队在一篇文章里讲了一次不太成功的尝试。
他们把大量历史 SQL 开放给 Agent,希望它从分析师过去的工作中找到答案。团队还检查了执行记录,确认 Agent 确实读了这些材料。然而,准确率提高还不到一个百分点^[6]^。
这件事有些出人意料。这些 SQL 是分析师为实际问题写的,Claude 又擅长读代码,照着已有的分析去做,为什么没有明显提高准确率?
要理解这次碰壁,可以把时间拨回 2024 年秋天,看看 Claude 做数据分析的方式是怎样变化的。
2024 年秋到 2025 年夏:从一份文件开始
2024 年 10 月,Claude 推出分析工具。用户上传 CSV,它就能编写并运行 JavaScript,清洗数据、完成计算、生成图表。[1]
这是一种很容易让人感到惊喜的体验。原来要自己查函数、写代码、调图表,现在交代需求,再追问几次,就能拿到一份像样的分析。对于熟悉手头数据的人,这种帮助尤其直接:知道哪里不对,就指出来;想换个角度,就接着问。
今天很多人用 WorkBuddy、千问办公、 Claude 和 Codex 做分析,也是从处理手头的表格开始,比如核对预算与实际支出的差异,或者比较各区域的销售表现。过去需要找分析师帮忙的工作,现在可以先自己试着完成。
不过,能这样用起来,也有使用者自己的一份功劳。他知道该上传哪张表,表里的数字是什么含义,哪些记录不该算进去。Claude 有疏漏,他能发现,也能及时纠正。
接着,人们很自然地希望再省掉一些麻烦:不要每次下载文件、上传资料,能不能让 Claude 自己去找?
2025 年 5 月,Integrations 让 Claude 可以通过远程 MCP 服务连接业务工具,获取项目历史、任务状态和组织知识。[2] 这样,用户少了一些手工搬运资料的麻烦。但找到了资料,具体该怎样分析,仍然需要用户交代清楚。
2025 年秋到 2026 年初:同样的分析,不必每次重来
到 2025 年秋天,Claude 已经能够创建和编辑 Excel、文档、PPT 等文件。一次对话可以从数据处理一直做到交付报告。[3]
看起来分析工作已经可以交给 AI 了,但用户很快遇到另一种重复劳动:重复说明报表要怎么排,哪些异常值得标出来,最后给谁看。用户希望有一种方法:上次已经反复解释、修改过的要求,下次最好能直接沿用。
同年 10 月发布的 Skills,正好提供了保存这些做法的方式。操作说明、脚本和参考资料可以放在一起,Claude 遇到相关任务时再读取。[4]
一个人反复试过、确认好用的分析步骤,可以写进 Skill,连同脚本、参考资料和检查要求一起分享给同事。同事接着使用时,就不必再从头摸索。
2026 年 1 月,Cowork 又把技能、连接器和子 Agent 打包成插件,首批就包括 Data 和 Finance。[5] 对想尝试的人来说,开始的门槛进一步降低。
不过,一套 Skill 在自己手里好用,换个人来用,未必同样顺利。原来的使用者熟悉业务,知道两份相似的报表该选哪份,也知道哪些数字需要再核对一下。这些经验,有些并没有写进 Skill。
同事拿到 Skill 后,可能选错报表,也可能没有发现结果异常。遇到问题,还是得请原来的人来帮忙。要让同事独立使用,就需要把选数的规则、常见的错误和核对方法也交代清楚。
2026 年上半年:在公司里用起来,才知道哪里会出错
6 月 3 日,Anthropic 数据团队公开复盘内部的自助分析实践。开头那次历史 SQL 实验,就记录在这篇文章里。[6]
原本的设想不难理解:分析师过去已经回答过许多问题,让 Claude 参考这些工作,应该能少走一些弯路。但实验的结果表明,即使读到了相关材料,Claude 也未必能把眼前的问题对应到正确的数据和定义上。
团队在文中介绍了另一种组织知识的办法。他们先整理一批有明确负责人、定义清楚的权威数据语义模型,形成语义层,再让 Claude 优先调用语义层中的指标;对于尚未覆盖的问题,则通过按业务领域整理的参考文档,说明相关表该怎样使用。[6]
Skills 在这里也有了具体职责:引导 Claude 先查哪类定义、到哪里找领域知识,以及遇到哪些情况需要澄清。
历史 SQL 仍然有用,但需要从中提炼出适用的规则和分析方法,整理成数据语义模型和知识模板,不能只把查询文件全部开放出去,就期待 Claude 自己用对。
这样,Claude 每次接到问题时,就有了一套经过整理的数据依据。数据团队确认过的定义和使用规则,也能供不同同事反复使用。
不过,语义模型和领域知识这些资料整理好了之后,后续的维护又出了问题。文章披露,他们的离线准确率曾在一个月内从约 95% 降到约 65%。数据语义模型在变,描述模型的技能文档却没有及时跟上。后来,团队把两者放进同一套更新流程,并把同一份技能同步到不同使用入口。[6]
原来,知识整理出来,也要随着业务继续维护。
2026 年下半年:从个人对话走进团队日常
8 月,Anthropic 发布后续文章,介绍怎样通过 Claude Tag,把这套分析能力带进 Slack。[7]
此前的重点是让分析更准确,接下来则要看业务同事怎样使用,大家如何协同。
很快,团队发现,只告诉 Claude 去哪里查数,得到的往往还只是数字。业务同事问“为什么下降了”“月底预计能做到多少”,期待的是有人帮自己把问题分析下去。于是,他们又补上预测、留存、漏斗和分析写作等技能。[7]
这些技能要交代的内容,比工具操作更细:什么情况下适合做预测,留存分析采用什么定义,结论应该怎样表达。分析师平时不一定会逐条讲出来的工作习惯,需要写成 Claude 能照着执行的说明。
即便如此,分析仍可能缺少关键背景。为此,他们又接入内部文档、讨论和事件索引,让 Claude 能够查找指标变化前后发生过什么。[7]
例如,要解释某天注册量下降,仅靠数据可以查出下降集中在哪个时段、哪个地区。如果再找到当天的故障记录,就多了一条值得核查的线索。
Slack 也让这项工作不再局限于一个人与 Claude 的对话。知道背景的同事可以补充信息,数据人员可以指出口径问题,Claude 再继续检查。相关讨论保留在同一条线程中,后来的人既能看到结论,也能看到当时的分析过程。[7]
从这里往后,企业得到的不只是一个更方便的问数入口。围绕同一个问题,业务背景、数据定义和核验结果开始有机会汇集起来。个人分析中依赖使用者随时补充的信息,可以在团队协作中得到补充和确认。
到了 10 月,Claude 又推出持续刷新的 Dashboard,支持查看图表背后的查询和数据更新时间,并与专业分析工具衔接。[8]
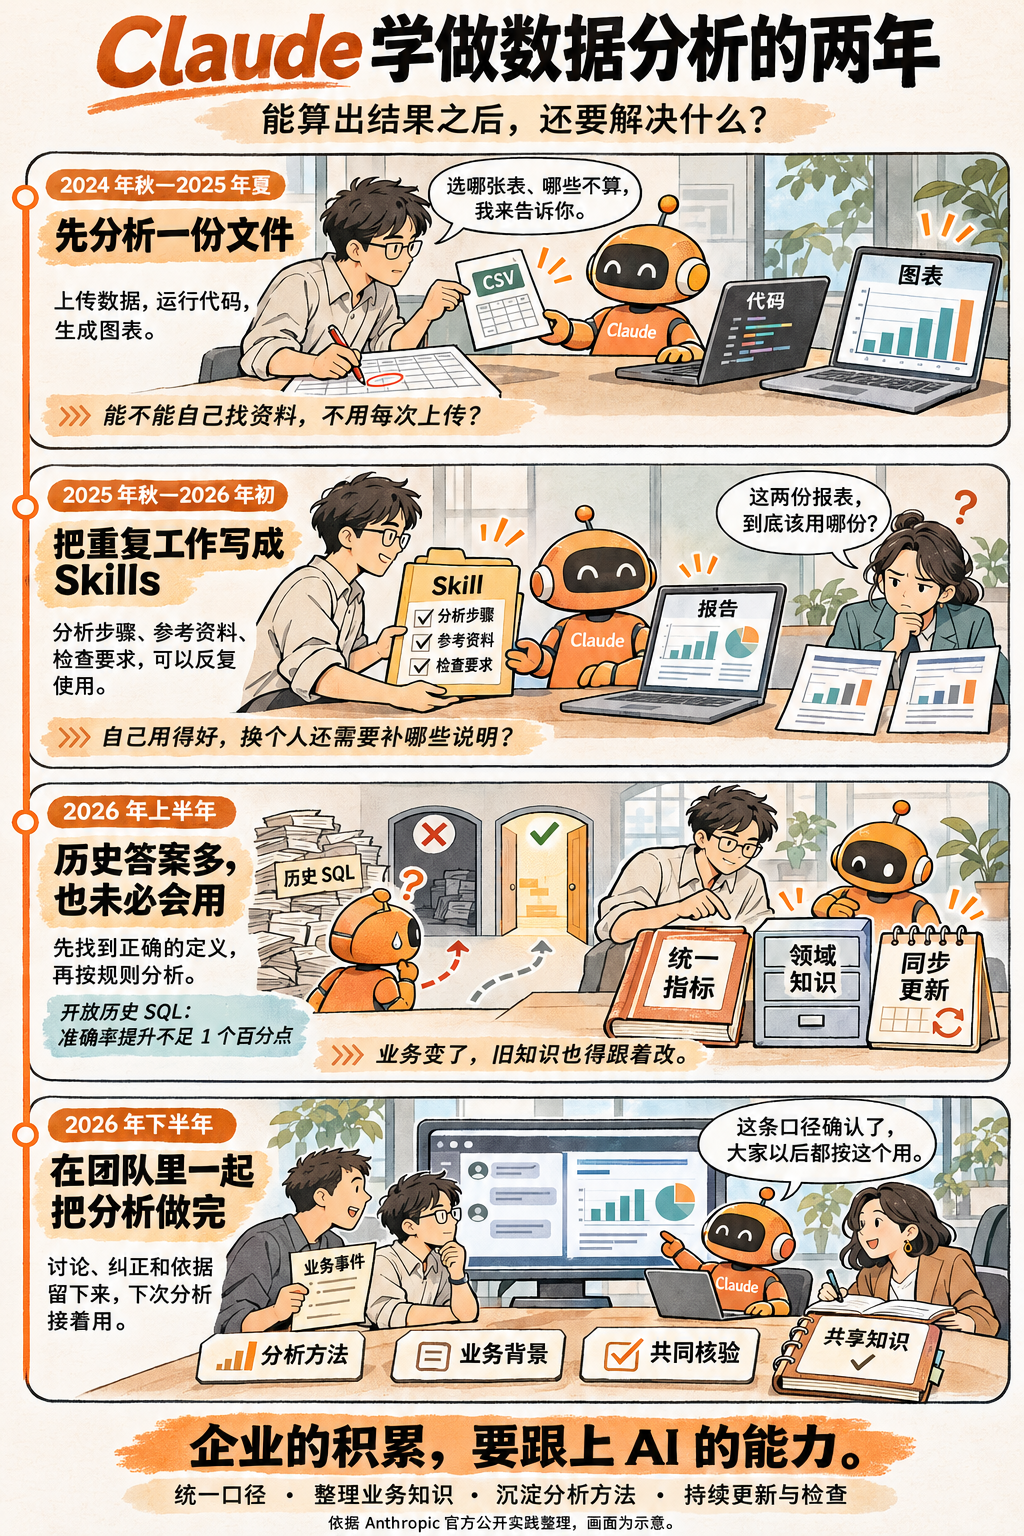
今天,一个人可以借助 WorkBuddy、Claude Cowork、OpenAI Codex,把手头的分析做得更快。但随着问题越来越深入、使用的人越来越多,也会陆续遇到 Claude 过去两年实践中遇到的问题:历史材料不少,关键时刻却找不到合适的依据;同一个问题换个人问,采用的口径就变了;一套分析上个月还好用,这个月业务调整了,却没有更新。
今天,通用 Agent 会成为越来越常见的数据分析入口,企业之间的差别,会更多地体现在它们为 Agent 准备了什么。一家公司已经确认的指标口径、积累的业务知识和验证过的分析方法,能否被 Agent 找到、正确使用,并随着业务变化及时更新,将直接影响员工能把分析做到多深、能有多放心。
这也会改变数据团队的工作。过去,分析师接到问题,再去找数据、对口径、查背景。今后,更多业务人员会直接向 Agent 提问,数据团队需要把其中反复使用的定义和规则提前整理好,把核验方法留下来,让更多分析不必每次都从头确认。
这正是 Aloudata 希望帮助企业完成的工作。我们从数据加工代码、报表和血缘关系中寻找已有的计算逻辑,帮助企业梳理分散的定义和依据,减少从头翻找、人工整理的工作;再把确认过的指标、维度和关联规则组织成可执行的语义层,让 Agent 按企业认可的口径取数和计算。
回看 Claude 的经历,模型还会继续升级,工具也会不断变化。企业一方面是继续让 AI 进入企业更多工作环节,另一方面是在使用的过程中,持续构建自己的企业知识库和语义库,让 Agent 越来越懂自己的业务,并让这种理解能够被整个团队反复使用。
参考资料
日期按官方文章标注;正文依据当前可见版本,不将发布日期等同于内部实践首次发生的时间。本文将公开实践串联为发展线索,相关行业判断为作者解读。
[1] Introducing the analysis tool in Claude.ai,2024-10-24
[2] Claude can now connect to your world,2025-05-01
[3] Claude can now create and edit files,2025-09-09
[4] Introducing Agent Skills,2025-10-16
[5] Customize Cowork with plugins,2026-01-30
[6] How Anthropic enables self-service data analytics with Claude,2026-06-03
[7] Self-service data analytics in Slack,2026-08-13
[8] Build live dashboards and animate explainers with Claude,2026-10-08
Topic Hub
AI 数据智能